本文为原创文章,未经本人允许,禁止转载。转载请注明出处。
1.Introduction
GitHub:https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet。
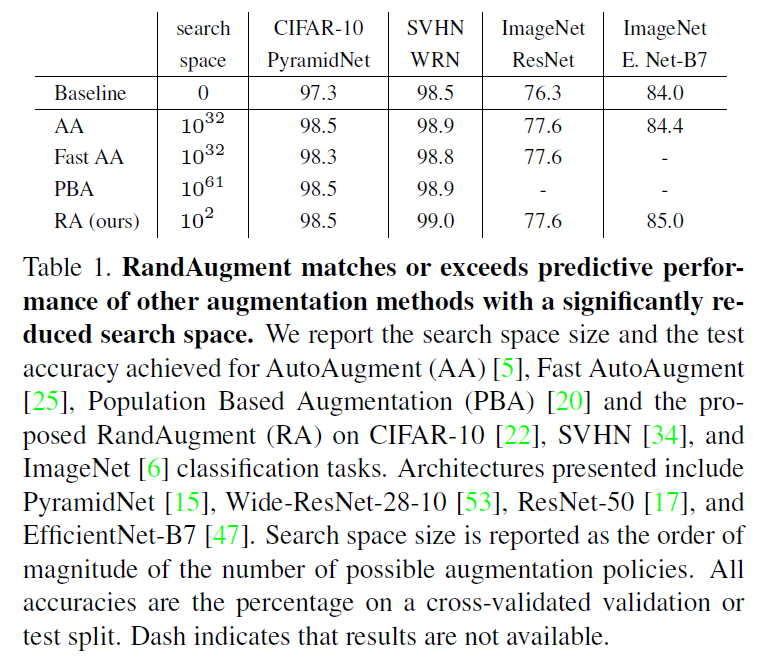
本文提出了一种实用的自动化数据增强方法,称为RandAugment。
如表1所示,RandAugment在显著缩小搜索空间的同时,其预测性能达到或超过其他数据增强方法:
2.Related Work
不再赘述。
3.Methods
作者认为像AutoAugment这种方法,需要先在小规模任务上搜索数据增强策略,再将其迁移到目标任务,不仅计算成本较高,而且无法保证迁移后的策略仍然最优。
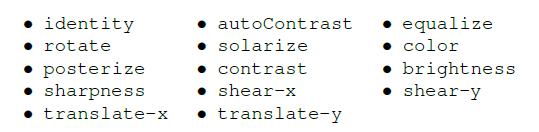
在RandAugment中,作者简化了这一流程,针对每张图像的数据增强策略,仅使用两个参数:$N$和$M$。$N$表示选择的图像处理方式的数量,假设一共有$K$种图像处理方式,每次从其中选择$N$种,那么潜在的搜索空间大小为$K^N$。此外,我们始终以均匀概率$1/K$选择一种图像处理方式。在我们的实验中,$K=14$,即一共有14种图像处理方式:
$M$表示图像处理方式的幅度,该幅度适用于所有图像处理方式。因此,RandAug算法就可以简单表示为:
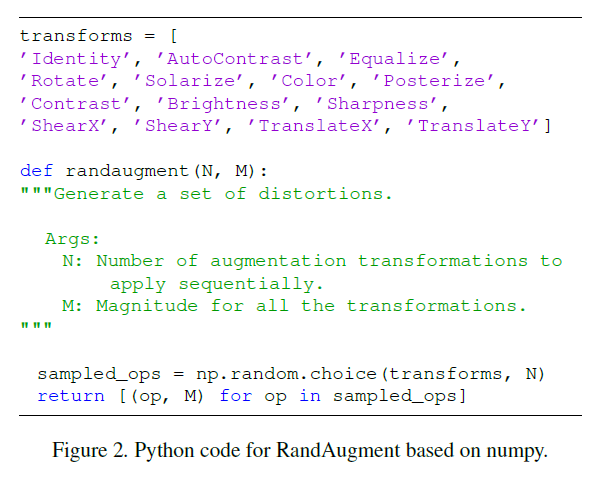
而参数$N$和$M$则通过网格搜索来确定。比如假设$N$有$\{1,2\}$两个取值,$M$有$\{2,6,10,14\}$四个取值,那么就需要尝试8种参数组合,最终选择表现最好的参数组合。
4.Results
4.1.Systematic failures of a separate proxy task
这部分主要是通过实验来证明将在小规模任务上学到的数据增强策略迁移到大规模的目标任务上,不一定能得到最优的结果。
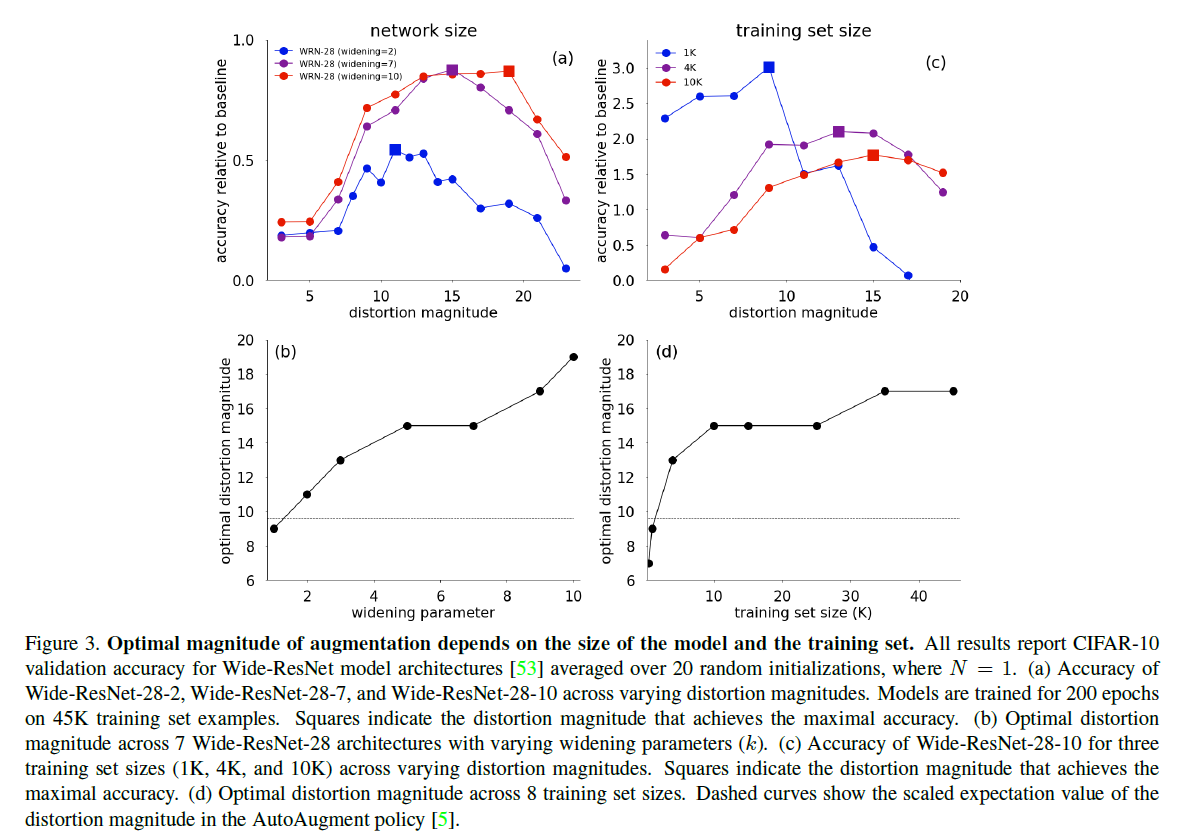
从Fig3(a)可以看出,对于不同规模的模型,最优参数$M$的取值是不同的。从Fig3(b)可以进一步看出,随着模型规模的增大,最优参数$M$的取值是单调递增的。Fig3(c)说明了不同规模的训练集,其最优参数$M$的取值也是不同的,从Fig3(d)可以进一步看出,随着训练集规模的增大,最优参数$M$的取值也是单调递增的。这也就印证了作者的观点,即小规模任务上学到的数据增强策略不一定能在大规模目标任务中得到最优的结果。
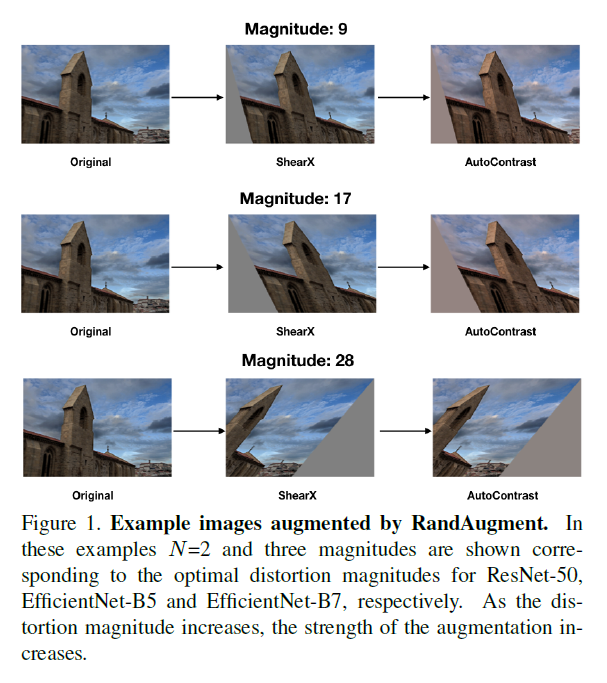
Fig1展示了使用RandAugment的一些图像处理效果:
4.2.CIFAR
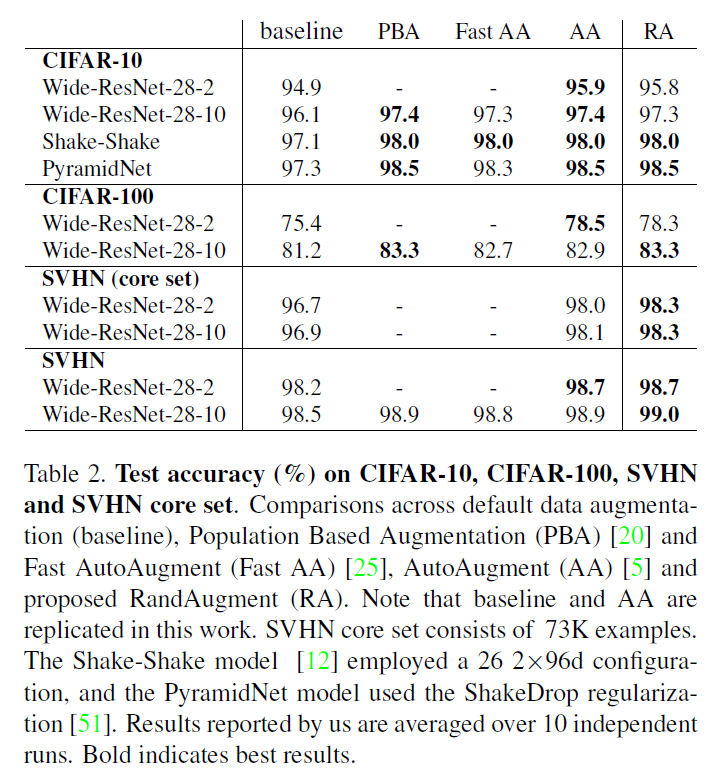
在CIFAR-10数据集上,对于所有参与比较的方法,默认的数据增强操作均包括翻转(flips)、填充后裁剪(pad-and-crop)以及cutout。对于超参数$N$和$M$,我们从训练集中留出5000个样本作为验证集,并根据模型在该验证集上的表现来选择这两个参数。超参的搜索范围为$N=3,M = \{ 4,5,7,9,11 \}$。
进一步在CIFAR-100数据集上,针对Wide-ResNet-28-2和Wide-ResNet-28-10两种网络架构,比较RandAugment的有效性。在留出的5000个验证样本上,设置$N=\{ 1,2 \},M=\{ 2,6,10,14 \}$。测试结果见表2:
4.3.SVHN
SVHN数据集包含一个由约73K张图像组成的核心训练集。此外,SVHN还包含约531K张难度相对较低的额外图像,可用于扩充训练数据。我们分别在使用和不使用这些额外数据的情况下,比较不同数据增强方法在Wide-ResNet-28-2和Wide-ResNet-28-10两种网络架构上的性能,测试结果见表2。
4.4.ImageNet
4.5.COCO
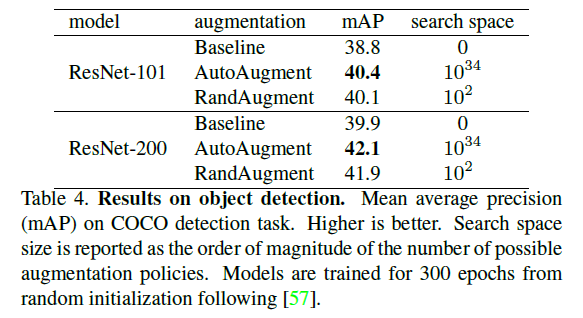
我们使用RetinaNet作为目标检测框架,并分别采用ResNet-101和ResNet-200作为backbone。所有模型均从随机初始化开始训练,共进行300个epoch。
4.6.Investigating the dependence on the included transformations
本部分讨论图像处理方式数量对性能的影响。
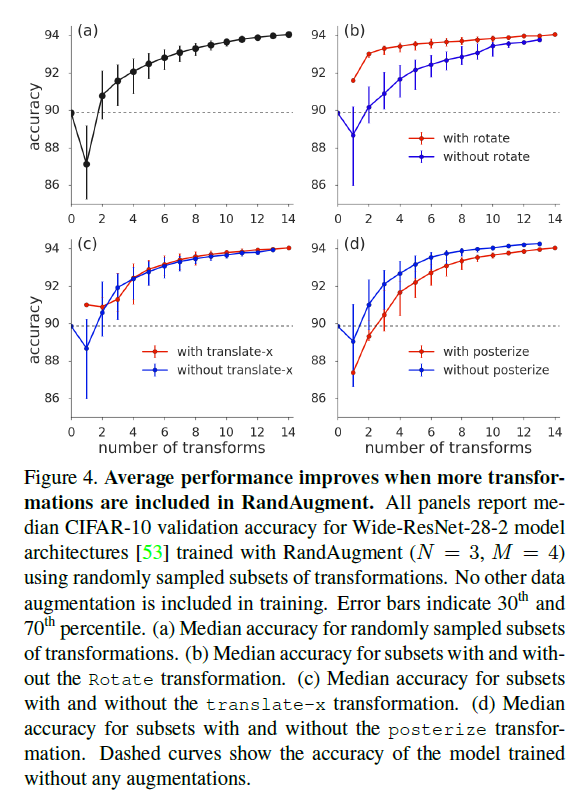
Fig4中,所有子图均报告了Wide-ResNet-28-2网络架构在CIFAR-10验证集上的准确率中位数。模型使用RandAugment进行训练,其中$N=3,M=4$。子图的横轴表示搜索空间中图像处理方式的总数量。从Fig4(a)可以看出,随着图像处理方式总数的增加,模型性能也逐步提升。Fig4(b)比较的是搜索空间中是否包含rotate这种图像处理方式对模型性能的影响。Fig4(c)比较的是搜索空间中是否包含translate-x这种图像处理方式对模型性能的影响。Fig4(d)比较的是搜索空间中是否包含posterize这种图像处理方式对模型性能的影响。
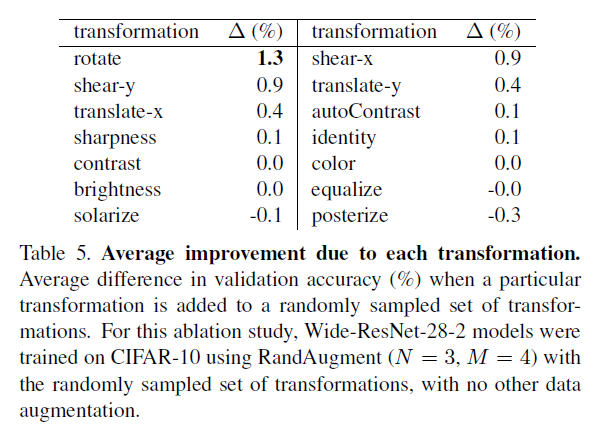
在表5中,按照每个图像处理方式对模型性能的帮助程度,从高到低列出了这些操作:
4.7.Learning the probabilities for selecting image transformations
RandAugment以相同的概率选择所有的图像处理方式。本部分主要讨论的是,如果通过一阶密度匹配近似(1st-order density matching approximation)来学习选择每种图像处理方式的概率,是否能够进一步提升模型性能?测试结果见表6:
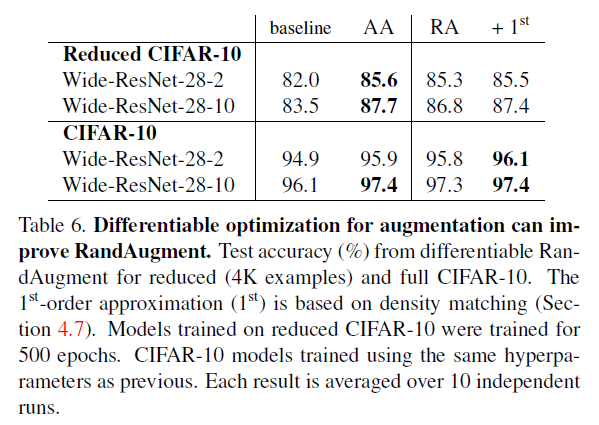
作者进一步发现,一阶方法的表现始终优于RandAugment,但其计算成本较高。
5.Discussion
不再赘述。
6.Appendix
6.1.Second order term from bilevel optimization
在第4.7部分,介绍了一阶方法,本部分介绍了二阶方法,不再详述。
6.1.1.Magnitude methods
虽然我们将控制图像处理幅度的参数$M$,应用于所有的图像处理方式,但在训练过程中,作者尝试了以下几种对幅度的进一步调整策略:
- Random Magnitude:在训练过程中,在两个指定数值之间,以均匀分布随机采样数据增强幅度。
- Constant Magnitude:在整个训练过程中,将数据增强幅度设置为一个固定值。
- Linearly Increasing Magnitude:在训练过程中,通过在两个指定数值之间进行线性插值,逐渐调整增强幅度。
- Random Magnitude with Increasing Upper Bound:与Random Magnitude类似,但其随机采样范围的上限会在训练过程中线性增大。
这几种幅度调整策略的效果见下:
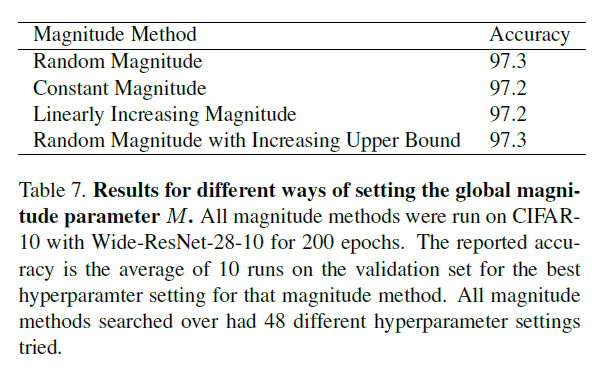
从表7可以看出,这几种调整策略的效果都差不多,所以最后选择了最简单的Constant Magnitude。
6.1.2.Optimizing individual transformation magnitudes
本部分主要讨论针对每种图像处理方式设置不同的增强幅度,对模型性能是否有帮助?
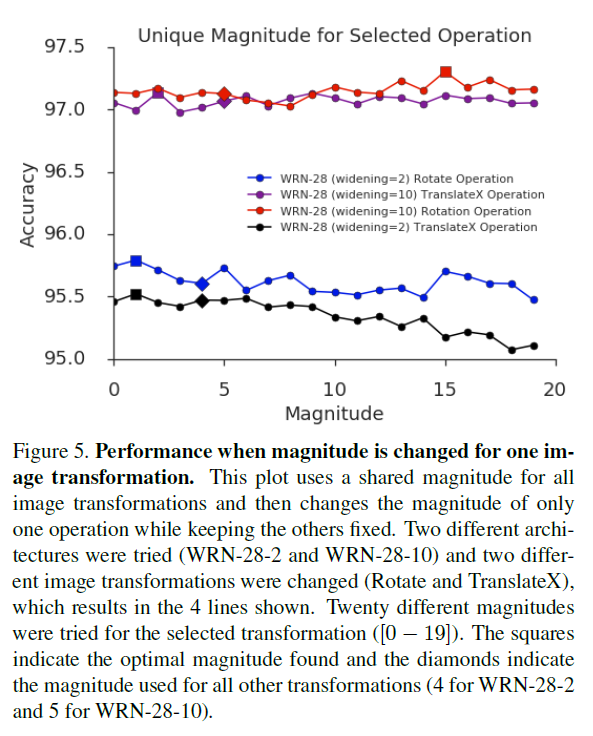
在Fig5中,以蓝色折线为例,当设置Rotate操作为不同幅度时,模型性能并没有太大差异。
6.2.Experimental Details
6.2.1.CIFAR
Wide-ResNet模型训练了200个epoch,学习率为0.1,batch size为128,weight decay为$5e-4$,使用cosine learning rate decay。Shake-Shake模型训练了1800个epoch,学习率为0.01,batch size为128,weight decay为$1e-3$,使用cosine learning rate decay。ShakeDrop模型训练了1800个epoch,学习率为0.05,batch size为64,weight decay为$5e-5$,使用cosine learning rate decay。
在CIFAR-10数据集上,对于Wide-ResNet-2和Wide-ResNet-10模型,其最优增强幅度分别为4和5。对于Shake-Shake (26 2x96d)和PyramidNet+ShakeDrop模型,其最优增强幅度分别为9和7。
6.2.2.SVHN
对于两个SVHN数据集,我们都在RandAugment之后应用cutout操作,与AutoAugment及相关方法的处理方式一致。对于SVHN核心训练集,我们在Wide-ResNet-28-2和Wide-ResNet-28-10两种模型上,均设置学习率为$5e-3$,weight decay为$5e-3$,使用cosine learning rate decay,共训练200个epoch。超参数设置为$N=3,M=\{ 5,7,9,11 \}$。对于Wide-ResNet-28-2和Wide-ResNet-28-10两种模型,我们发现最优增强幅度均为9。
对于完整的SVHN数据集,我们在Wide-ResNet-28-2和Wide-ResNet-28-10两种模型上,训练参数设置为:学习率为$5e-3$,weight decay为$1e-3$,使用cosine learning rate decay,共训练160个epoch。超参数设置为$N=3,M=\{ 5,7,9,11 \}$。对于Wide-ResNet-28-2,我们发现最优增强幅度为5;对于Wide-ResNet-28-10,我们发现最优增强幅度为7。
6.2.3.ImageNet
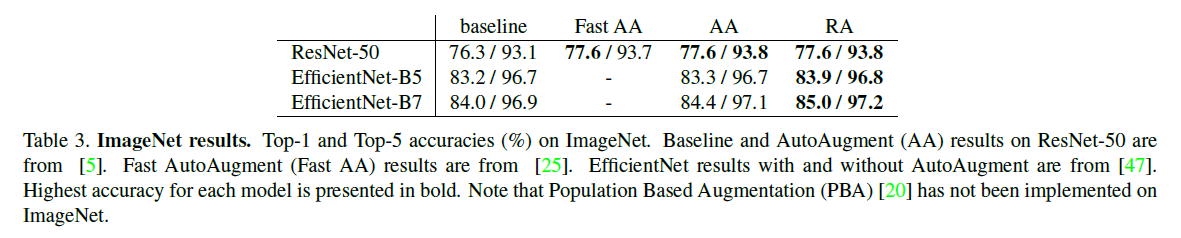
使用ResNet-50,共训练了180个epoch。图像尺寸为$224 \times 224$,weight decay为0.0001,momentum参数设置为0.9。初始学习率为0.1,并根据batch size与256的比值进行缩放。global batch size为4096,分配到32个worker上进行训练。超参数设置为$N=\{ 1,2,3 \},M=\{5,7,9,11,13,15 \}$。最优参数组合为$N=2,M=9$。
EfficientNet的超参数设置和训练计划遵循其原始论文。模型共训练了350个epoch,batch size为4096。学习率设为0.016,并根据batch size与256的比值进行缩放。使用RMSProp优化器,其中momentum系数为0.9,epsilon为0.001,decay为0.9。weight decay设为$1e-5$。对于EfficientNet B5,输入图像尺寸为$456 \times 456$;对于EfficientNet B7,输入图像尺寸为$600 \times 600$。对于EfficientNet B5,我们尝试了$N=2$和$N=3$,发现二者性能基本相同。我们发现EfficientNet B5的最优增强幅度为$M=17$,搜索范围为$M=\{ 8,11,14,17,21 \}$。对于EfficientNet B7,最优参数组合为$N=2,M=28$,参数$M$的搜索范围为$M= \{ 17,25,28,31 \}$。
在ImageNet数据集上,我们使用了水平翻转和随机裁剪作为默认的数据增强方法,并且在执行RandAugment之前应用这些操作。模型训练和评估使用ImageNet标准的训练集和验证集划分。
6.3.COCO
除了RandAugment之外,我们还使用了水平翻转和scale jitters作为额外的数据增强方法。我们使用了与图像分类任务相同的数据增强变换操作列表。学习率为0.08,weight decay为$1e-4$,focal loss的参数设置为$\alpha = 0.25,\gamma=1.5$。我们将$N$设置为1,$M$的搜索范围在4-9之间。我们发现,对于ResNet-101和ResNet-200,最优的$M$分别为5和6。
7.原文链接
👽RandAugment:Practical automated data augmentation with a reduced search space