本文为原创文章,未经本人允许,禁止转载。转载请注明出处。
1.Introduction
自动学习数据增强策略是一个重要但尚未解决的问题。在本文中,我们旨在自动化为目标数据集寻找有效数据增强策略的过程。在我们的实现中,每一种策略都会包含多种可能的数据增强操作及其顺序,其中每个操作都是一种图像处理函数(例如平移、旋转或颜色归一化),以及应用该操作的概率和施加的幅度大小。我们使用一种搜索算法来寻找这些操作的最佳选择与组合顺序,使得用其训练神经网络能够获得最高的验证集准确率。在实验中,我们采用强化学习作为搜索算法,但我们相信,如果使用更好的搜索算法,结果还有可能进一步提升。
我们的大量实验表明,AutoAugment在两种场景下都使模型性能取得了显著提升:
- AutoAugment可以直接应用于目标数据集以寻找最佳增强策略,记为AutoAugment-direct。
- 学到的增强策略可以迁移到新的数据集上,记为AutoAugment-transfer。
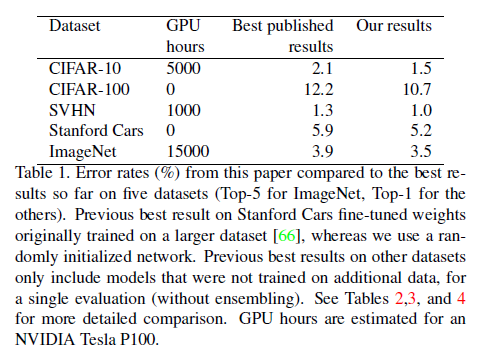
如表1所示,在CIFAR-10、CIFAR-100、SVHN、Stanford Cars、ImageNet这五个数据集上,在使用了AutoAugment之后,模型性能相比之前的最好成绩有了进一步的提升。其中,CIFAR-100使用了在CIFAR-10数据集上通过AutoAugment学习到的数据增强策略,Stanford Cars使用了在ImageNet数据集上通过AutoAugment学习到的数据增强策略。
2.Related Work
不再赘述。
3.AutoAugment: Searching for best Augmentation policies Directly on the Dataset of Interest
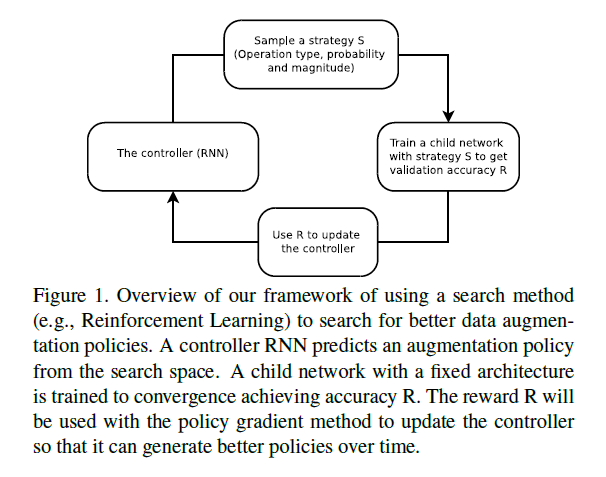
我们的方法使用强化学习的思想来搜索最佳的数据扩展策略。控制器会预测生成一个数据增强策略$S$,其中包含要使用哪些图像处理操作、在每个batch中使用该操作的概率,以及操作施加的幅度大小等信息。然后一个有着固定结构的子网络会使用这个策略$S$进行训练直至收敛,在验证集上得到一个准确率$R$,然后这个$R$会被反馈回来用于更新控制器。
整体流程和NAS基本一致。
👉Search space details
在我们的搜索空间中,一个数据增强策略$S$由5个子策略组成,其中每个子策略又包含两个按顺序执行的图像操作。此外,每种图像操作还关联两个超参数:执行该操作的概率、操作施加的幅度大小。
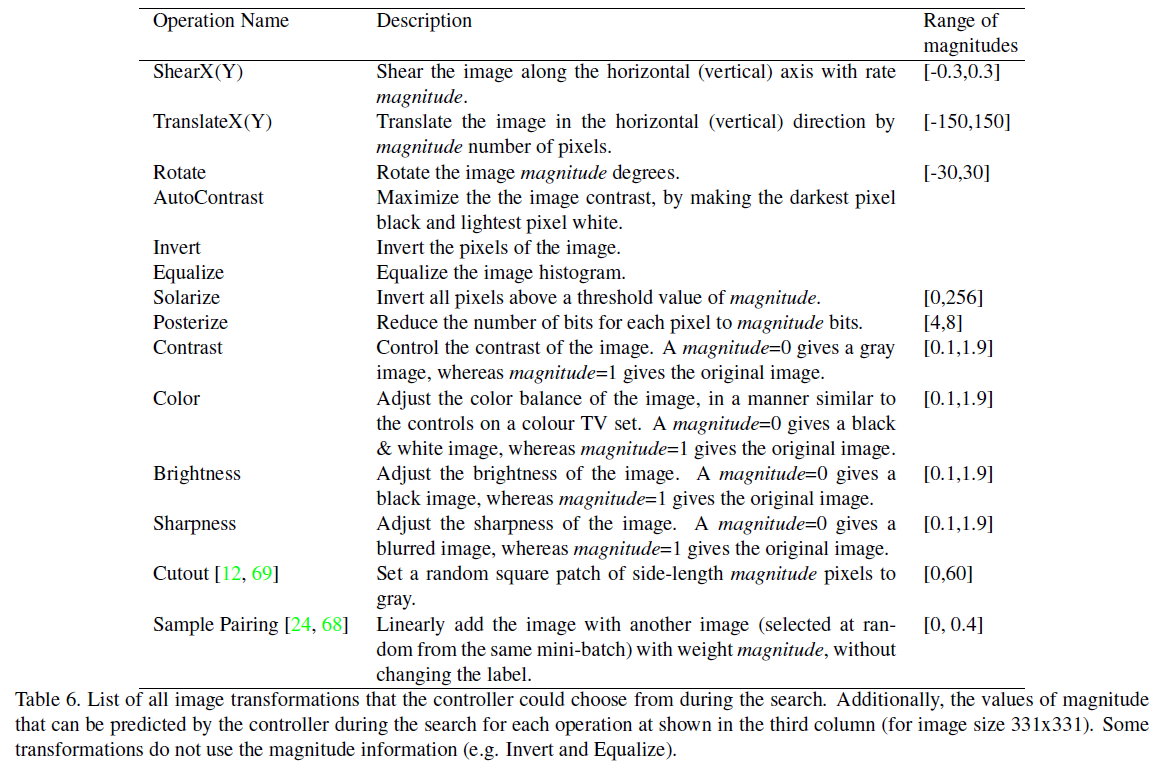
图像操作主要通过调用PIL(一个流行的Python图像处理库)来实现,PIL详见https://pillow.readthedocs.io/en/stable/。我们共使用了16种图像操作:ShearX/Y、TranslateX/Y、Rotate、AutoContrast、Invert、Equalize、Solarize、Posterize、Contrast、Color、Brightness、Sharpness、Cutout、Sample Pairing。其中,每种操作都有一个默认的幅度取值范围,我们将这个幅度范围离散化为10个等间隔取值。此外,每种操作还对应有被施加概率的取值范围,我们将这个概率范围离散化为11个等间隔取值。
这样的话,一个子策略对应的搜索空间大小为$(16 \times 10 \times 11)^2$,因此,一个完整的策略$S$所包含的搜索空间大小为$(16 \times 10 \times 11)^{10} \approx 2.9 \times 10^{32}$。
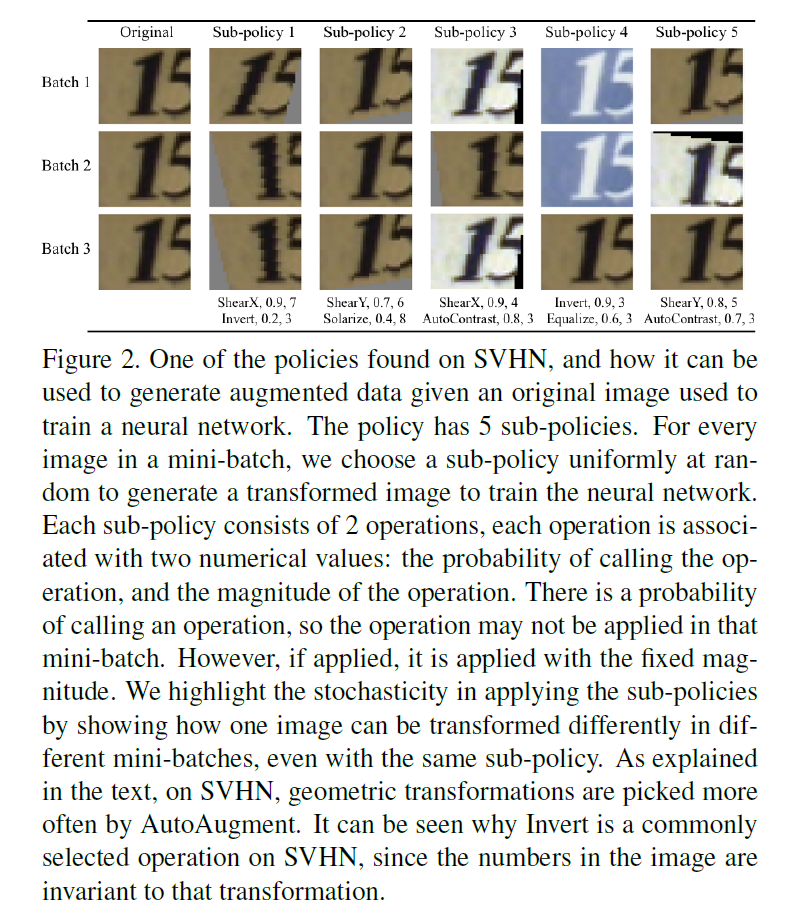
表2是在SVHN上的一个示例,该策略一共包含5个子策略。对于mini-batch中的每一张图像,我们都会均匀随机地选择一个子策略,对图像进行变换以训练神经网络。每个子策略由两个操作组成,而每个操作都关联两个数值参数:执行该操作的概率,以及操作的幅度大小。由于存在执行概率,某个操作在该mini-batch中可能不会被应用,但如果被应用,则会以固定的幅度执行。
表6给出了所有16种操作及其默认取值范围。需要注意的是,在我们的搜索空间中并没有显式包含“无变换”这种操作,但这种情况是隐式实现的,即只需将某个操作的执行概率设为0即可达到不做任何变换的效果。
👉Search algorithm details
控制器为RNN。控制器的训练采用PPO的方式,即有两个结构一样的RNN,一个用于采样策略$S$,另一个则基于得到的reward更新自己的参数。RNN设置了30个softmax输出,因为一共有5个子策略,每个子策略又包含2个图像操作,每个图像操作又涉及操作类型、幅度、概率等3个参数,所以一共需要$5 \times 2 \times 3 = 30$个输出。
👉The training of controller RNN
在实验中,单独划分出一个验证集,用于衡量子网络的泛化能力。子网络使用经过数据增强的训练数据进行训练,这些增强数据由5个子策略作用于训练集得到,且训练集不包含验证集。对于mini-batch中的每个样本,随机选择5个子策略中的一个,对该图像执行数据增强。随后,在验证集上评估子网络,计算其准确率,并将准确率作为reward,用于训练控制器。对于每个数据集,控制器大约采样15000套数据增强策略。
👉Architecture of controller RNN and training hyperparameters
控制器的训练和超参数设置和NASNet完全一致。
最终,选择性能最好的5个策略,将其包含的25个子策略一起用于训练各个数据集上的模型。
4.Experiments and Results
4.1.CIFAR-10, CIFAR-100, SVHN Results
CIFAR-10包含50000个训练样本,但为了减少数据增强策略过程中训练子网络所需的时间,我们在一个规模更小的数据集上搜索最佳策略。我们将这个数据集称为reduced CIFAR-10,它从CIFAR-10中随机选取4000个样本。我们发现,在训练时间固定的情况下,与其使用更多的训练数据、但训练较少的epoch,不如让子模型训练更多的epoch,这样会更加有效。对于子模型的网络架构,我们使用一个较小的Wide-ResNet-40-2模型(来自论文“S. Zagoruyko and N. Komodakis. Wide residual networks. In British Machine Vision Conference, 2016.”),并训练了120个epoch。使用较小的Wide-ResNet是为了提高计算效率,因为每个子模型都需要从头开始训练,以便计算用于更新控制器的梯度。weight decay设为$10^{-4}$,学习率设为0.01并使用cosine learning rate decay。
在reduced CIFAR-10上搜索得到的策略,随后被用于在CIFAR-10、reduced CIFAR-10和CIFAR-100数据集上训练最终模型。
baseline预处理遵循当时先进的CIFAR-10模型所采用的常规做法:对数据进行标准化、以50%的概率进行水平翻转、进行zero-padding和随机裁剪、最后应用尺寸为$16 \times 16$像素的cutout操作。AutoAugment策略是在标准baseline预处理的基础上额外应用的:对于一张图像,我们首先执行现有baseline方法所提供的数据增强操作,然后应用AutoAugment策略,最后再应用cutout操作。我们没有对cutout区域的大小进行优化,而是直接使用论文“T. DeVries and G. W. Taylor. Improved regularization of convolutional neural networks with cutout. arXiv preprint arXiv:1708.04552, 2017.”中建议的16像素。需要注意的是,由于cutout本身也是搜索空间中的一种操作,因此同一张图像可能会被执行两次cutout,第一次使用通过搜索学习得到的区域大小,第二次使用固定的区域大小。在实际应用中,由于第一次应用cutout操作的概率较低,因此对于给定图像,通常只会执行一次cutout。
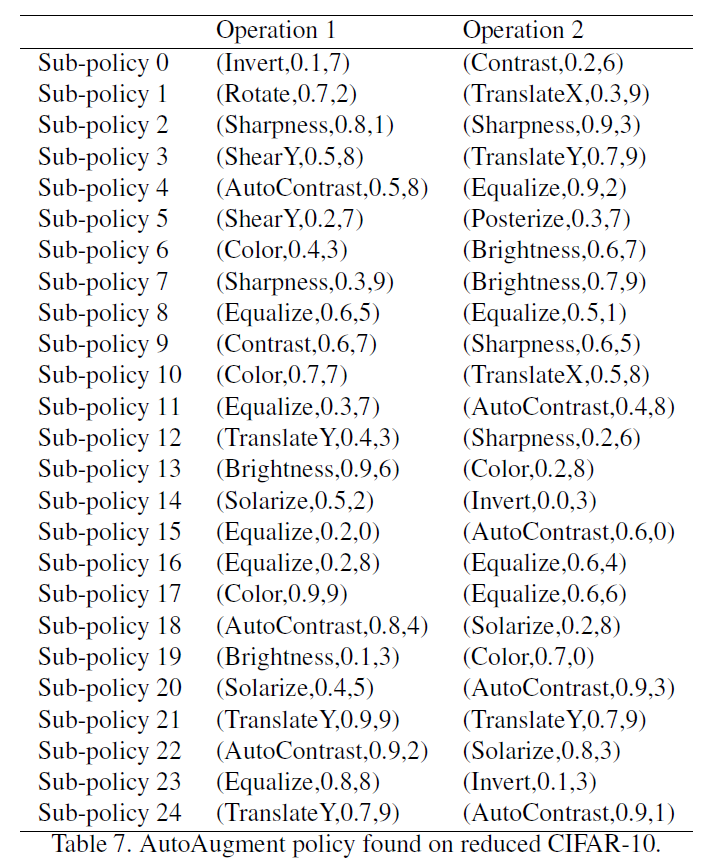
在reduced CIFAR-10上搜索到的最优的5个策略(共25个子策略):
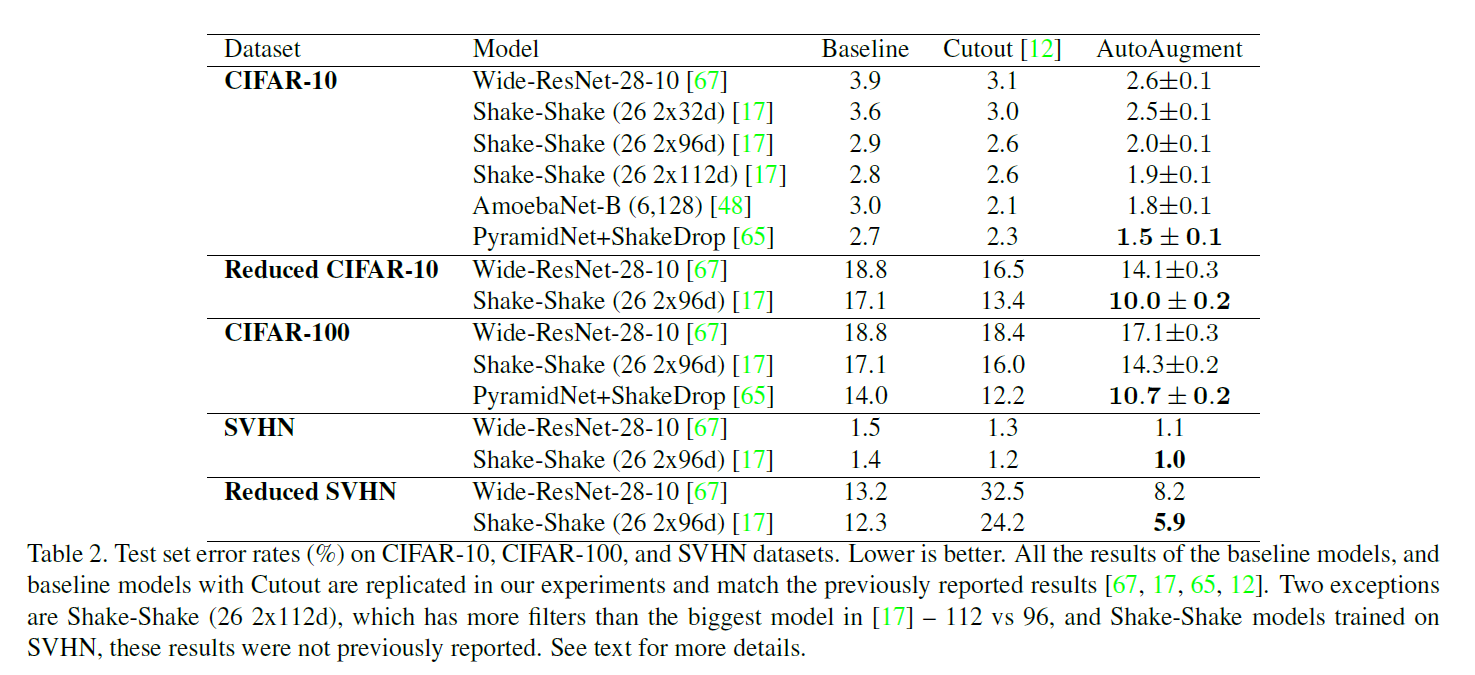
所有报告的实验结果均为5次运行的平均值。
👉CIFAR-10 Results
👉CIFAR-100 Results
见表2。
👉SVHN Results
SVHN数据集包含73257个训练样本(也称为“核心训练集”)以及额外的531131个训练样本。测试集包含26032个样本。为了节省搜索过程中的时间,我们从核心训练集中随机抽取了1000个样本,构建了一个reduced SVHN数据集。在reduced SVHN上搜索到的数据扩展策略会被用于reduced SVHN和SVHN。子模型的网络架构和训练流程与前面CIFAR-10实验中使用的完全相同。
在reduced SVHN上搜索到的策略见下:
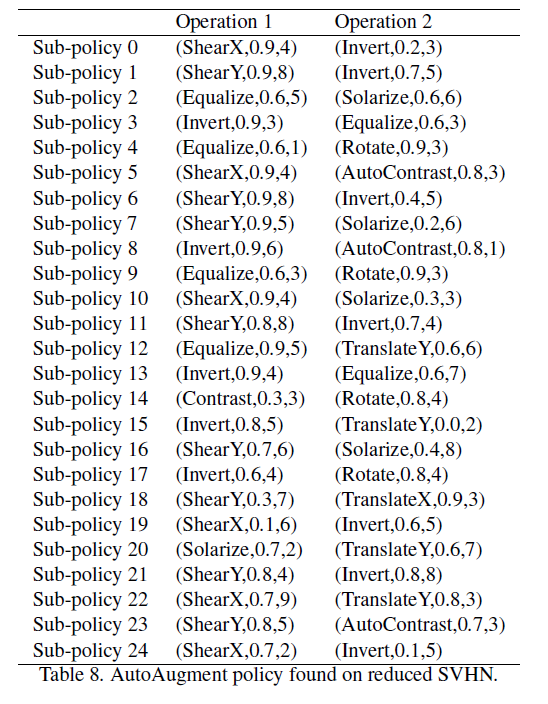
验证集通过从训练集中划分出最后7325个样本来构建。结果见表2。
4.2.ImageNet Results
与前面的实验类似,我们使用ImageNet训练集的一个缩减子集来搜索数据增强策略,该子集包含随机选择的120个类别和6000个样本。我们使用cosine learning rate decay,对Wide-ResNet 40-2模型进行200个epoch的训练。weight decay设为$10^{-5}$,学习率设为0.1。
在reduced ImageNet上搜索到的最优策略见下:
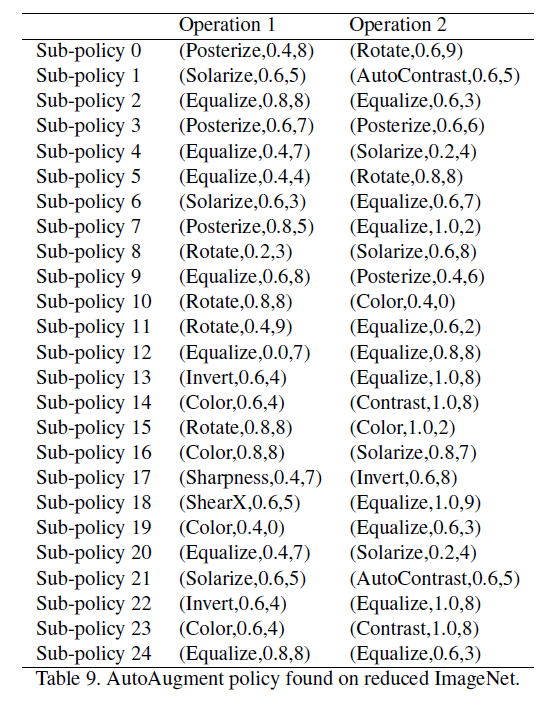
Fig3展示了其中一个表现最好的数据增强策略:
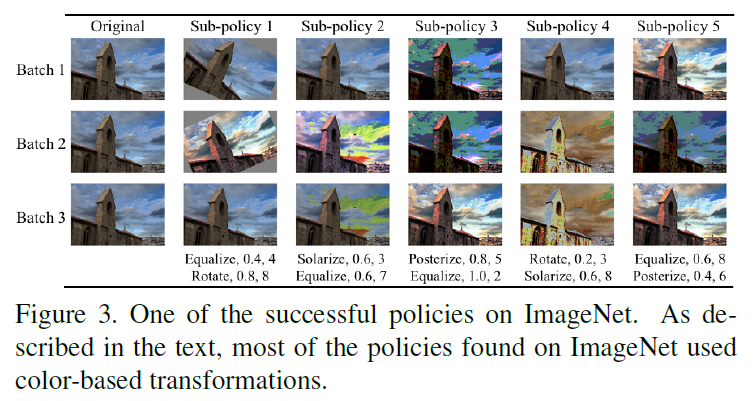
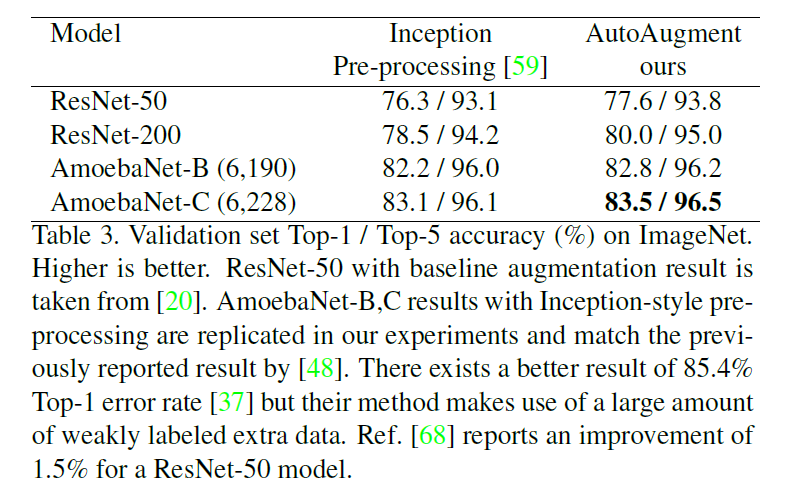
同样,我们将表现最好的5个策略合并,共得到25个子策略,以构建用于ImageNet训练的最终数据增强策略。随后,我们使用这一数据增强策略,在完整的ImageNet数据集上,从头开始训练ResNet-50和ResNet-200模型,训练持续了270个epoch。batch size为4096,学习率为1.6。我们分别在第90、180和240个epoch时,将学习率降低至原来的十分之一。采用标准的Inception风格的预处理,其中包括将像素值缩放至$[-1,1]$范围内,以50%的概率进行水平翻转,以及对颜色进行随机扰动。实验结果见表3:
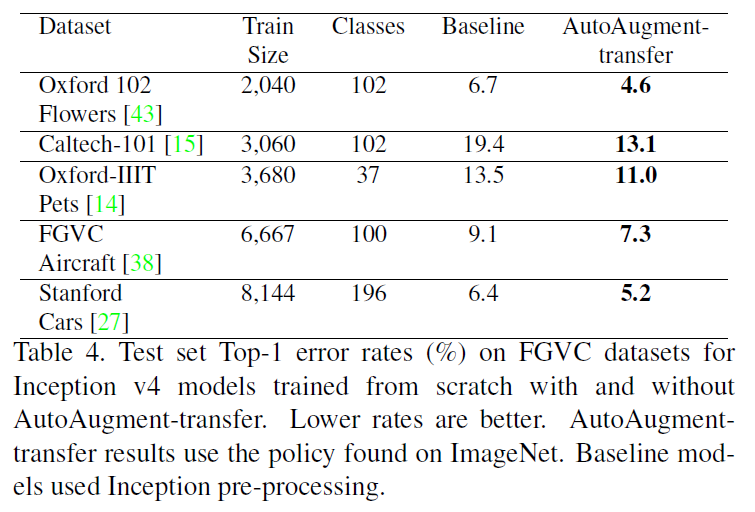
4.3.The Transferability of Learned Augmentation policies to Other Datasets
将在ImageNet上学到的数据增强策略迁移到其他数据集上的表现:
5.Discussion
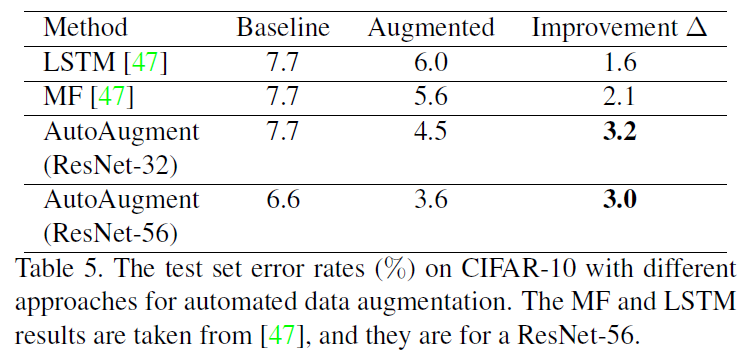
与之前提出的自动化数据增强方法进行比较:
5.1.Ablation experiments
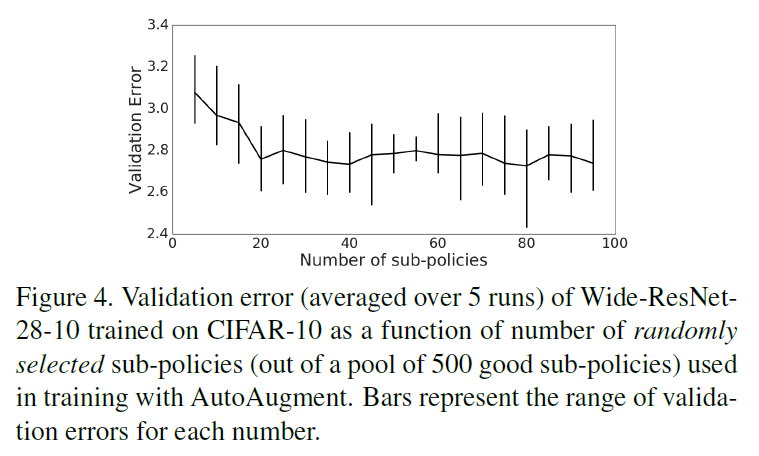
使用不同数量的子策略对验证集准确率的影响: