本文为原创文章,未经本人允许,禁止转载。转载请注明出处。
1.Introduction
直接将NAS或类似的网络结构搜索方法应用于ImageNet这样的大规模数据集,会产生非常高的计算成本。因此,我们提出首先在一个代理数据集上搜索优秀的网络架构,例如规模较小的CIFAR-10数据集,然后将学习到的网络架构迁移到ImageNet数据集。我们通过设计一种新的搜索空间(称为NASNet搜索空间)来实现这种可迁移性,使得需要搜索的架构复杂度不依赖于网络的深度和输入图像的尺寸。更具体的说,我们搜索空间中的所有卷积神经网络,都是由具有相同结构、但拥有不同权重的卷积层(称为cell)组成的。因此,搜索最佳卷积神经网络架构的问题,就被简化为搜索最佳cell结构的问题。搜索最佳cell结构主要具有两个优点:1)相比搜索整个网络架构,搜索cell的速度要快得多;2)cell本身更有可能泛化到其他问题。
2.Related Work
不再赘述。
3.Method
NAS的结构见下:
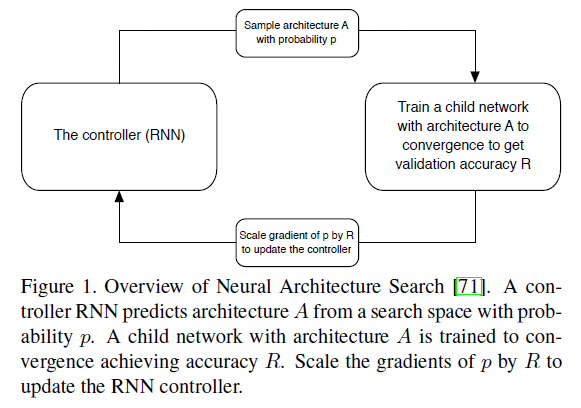
NASNet的灵感来源于,在CNN架构设计中,研究人员经常通过重复使用某些基本结构来取得最先进的性能。因此,我们可以使用控制器RNN来预测一种通用的cell。随后,我们便可以将这种cell连续堆叠,以处理具有不同空间尺寸和通道深度的输入。
卷积神经网络由重复出现的卷积cell组成,每个cell具有相同的架构,但拥有不同的权重。为了能够方便的构建适用于任意尺寸图像的可扩展网络,我们需要两种类型的卷积cell,它们分别完成两种主要功能:1)输出与输入具有相同空间尺寸的feature map;2)输出的feature map高度和宽度均缩小为输入的一半。我们将前者命名为Normal Cell,后者命名为Reduction Cell。对于Reduction Cell,通过将cell输入的初始操作的步长设置为2,从而降低feature map的高度和宽度。
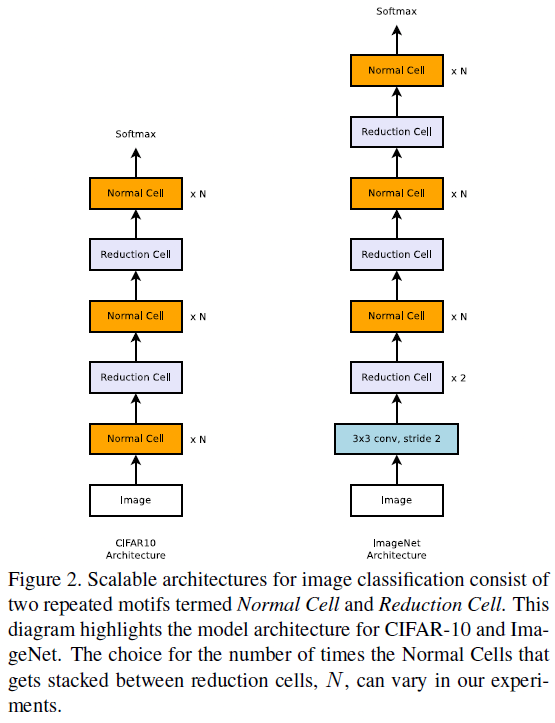
Fig2展示了我们在CIFAR-10和ImageNet中放置Normal Cell和Reduction Cell的方式。Normal Cell和Reduction Cell可以采用相同的架构,但我们通过实验发现,分别学习两种架构会带来更好的效果。
控制器RNN负责预测每种cell的结构。控制器RNN在预测cell结构时会分为$B$个block,每个block输出5个预测结果,这5个预测结果分别由5个softmax输出,均为离散变量,也就是说,控制器RNN会有$5B$个softmax输出,其中每个block的结构见下:
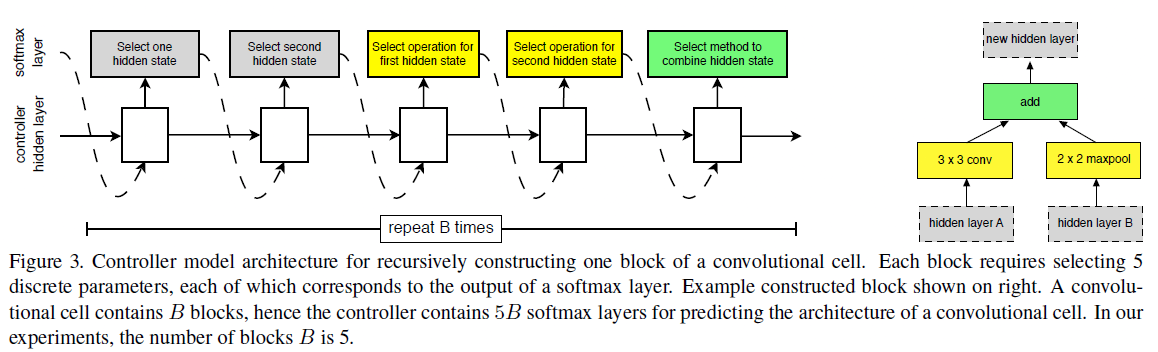
对于每个block,先预测使用哪两个hidden state,这里的hidden state指的就是CNN中的feature map。然后预测对这两个feature map分别执行什么操作,最后预测将这两个处理后的feature map如何combine起来。Fig3右侧就是一个例子,即一个block预测得到的卷积层结构。
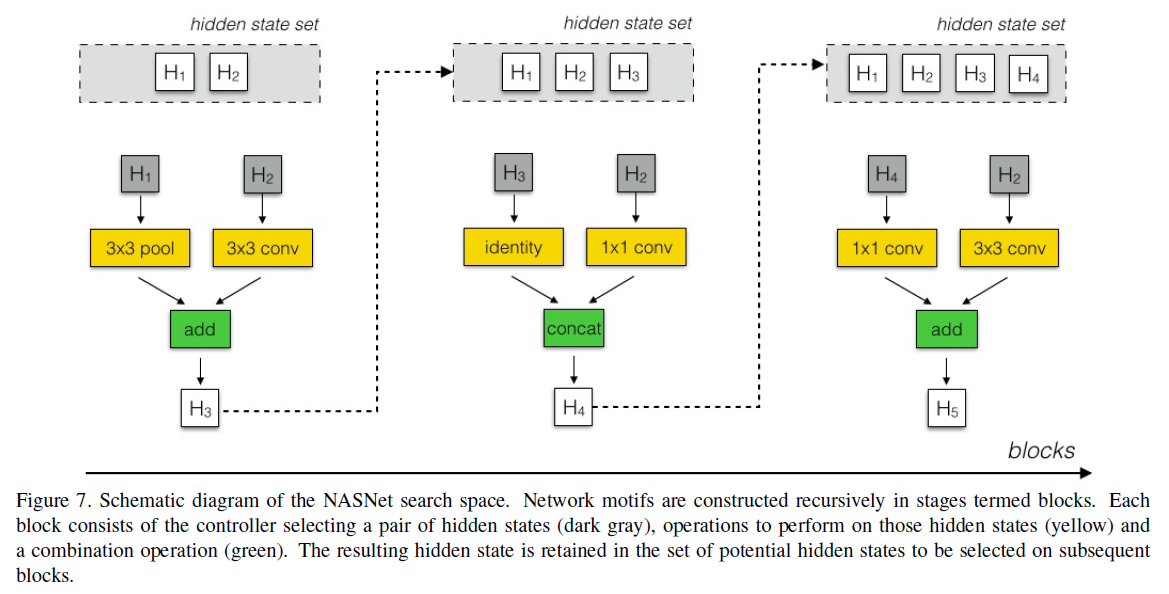
那么将多个block预测的结构组合起来就是一个cell,如下图Fig7所示:
其中:
- 第一个block的输入$H_1,H_2$来自前面两个cell的输出,比如有连续三个cell:cell1、cell2、cell3。cell1的输出为$H_1$,cell2的输出为$H_2$,此时cell3的输入就是$H_1,H_2$。如果cell3前面不足两个cell,cell3可使用输入图像作为补充输入。
- 第二个block的输入来自$H_1,H_2,H_3$,RNN可自行预测选择哪两个feature map,比如通过一个softmax来预测分别选择这三个feature map的概率。后面的block类似,比如第三个block的输入来自$H_1,H_2,H_3,H_4$。
在Fig3中,对两个feature map,都要预测一个操作(黄色框),可选的操作有如下:
- identity
- 1x3 then 3x1 convolution
- 1x7 then 7x1 convolution
- 3x3 dilated convolution
- 3x3 average pooling
- 3x3 max pooling
- 5x5 max pooling
- 7x7 max pooling
- 1x1 convolution
- 3x3 convolution
- 3x3 depthwise-separable conv
- 5x5 depthwise-separable conv
- 7x7 depthwise-separable conv
在Fig3中,还要预测两个feature map的combine方式(绿色框),可选的combine方式有element-wise加法和concat。
此外,在一个cell中,未被使用的hidden state(即feature map)会沿着通道维度进行拼接,形成cell的最终输出。
为了让控制器RNN能够同时预测Normal Cell和Reduction Cell,我们只需让控制器总共执行$2 \times 5B$次预测。其中,前$5B$次预测用于生成Normal Cell,后$5B$次预测用于生成Reduction Cell。
4.Experiments and Results
所有架构搜索均在CIFAR-10图像分类任务上进行。控制器RNN采用PPO的方式进行训练。
Fig4展示了表现最佳的Normal Cell和Reduction Cell的架构。
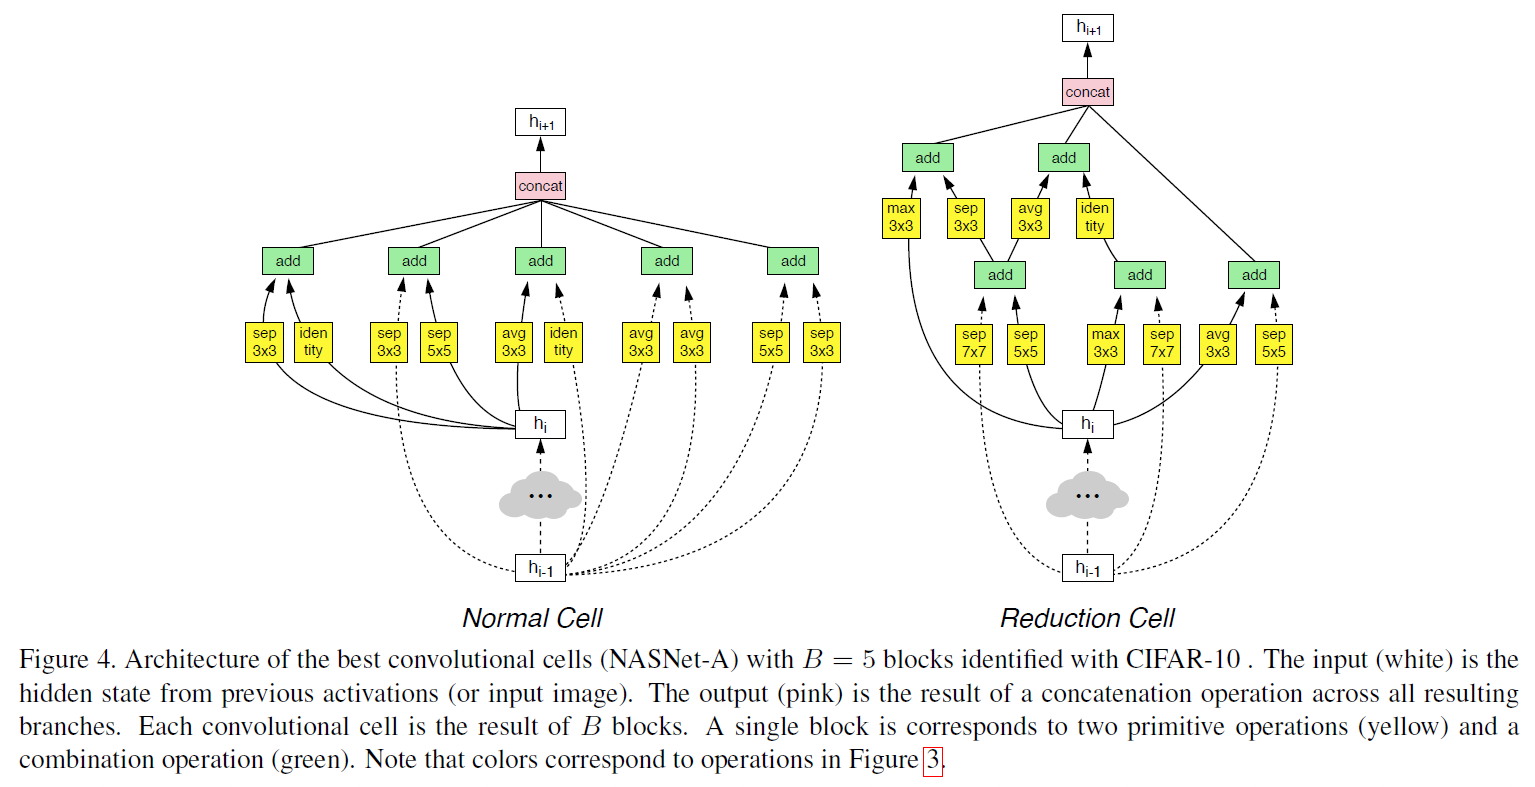
我们将三种表现较好的搜索结果对应的网络分别命名为NASNet-A,NASNet-B和NASNet-C。
在学习到cell结构后,可以通过调整以下两个超参数,为特定任务构建最终的网络:1)cell的重复次数$N$;2)初始cell(个人注解:即网络中的第一个cell)中filter的数量,即channel数量。在确定初始cell中filter数量之后,每当卷积操作的步长为2时,就将filter数量增加一倍。最后,我们定义了一种简洁的记法,例如$4@64$,用于表示网络中的这两个参数,其中,4表示cell的重复次数,64表示网络倒数第二层的filter数量。
值得注意的是,在训练NASNet时,我们发现了一种有效的正则化方法,称为ScheduledDropPath。它是对DropPath方法的改进。在原始DropPath中,训练过程中会以某个固定概率随机丢弃cell内部的计算路径。而在我们的改进版本ScheduledDropPath中,计算路径被丢弃的概率会随着训练过程线性增加。我们的实验发现,普通DropPath对NASNet的效果并不好,而ScheduledDropPath能够显著提高NASNet在CIFAR-10和ImageNet实验中的最终性能。
DropPath论文:G. Larsson, M. Maire, and G. Shakhnarovich. Fractalnet: Ultra-deep neural networks without residuals. arXiv preprint arXiv:1605.07648, 2016.。
4.1.Results on CIFAR-10 Image Classification
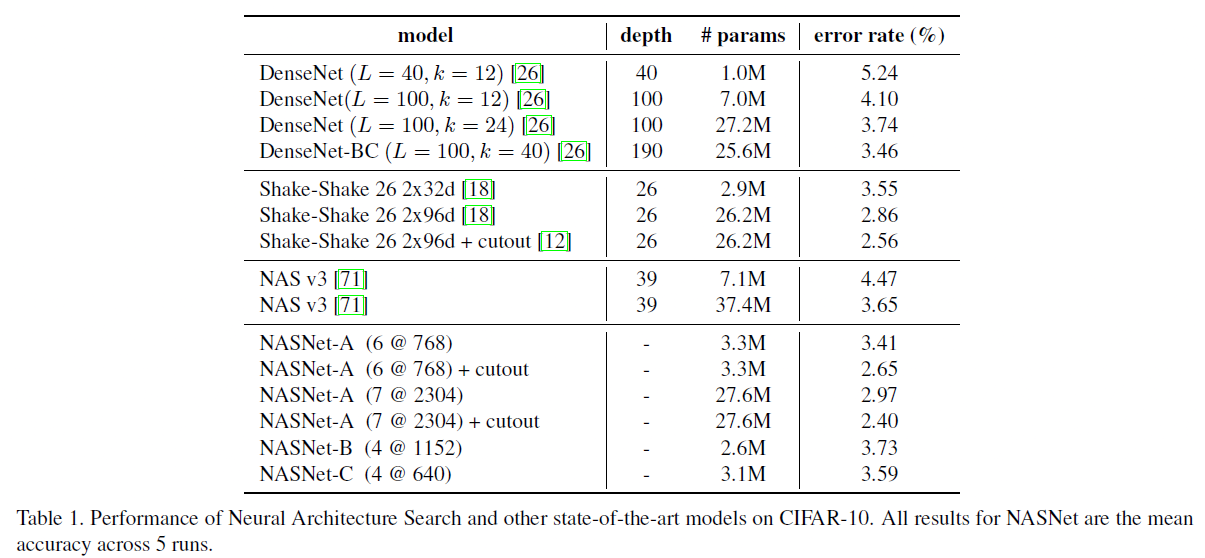
对于CIFAR-10图像分类任务,网络结构如Fig2所示,我们将cell的重复次数$N$设置为4或6。结果见表1:
4.2.Results on ImageNet Image Classification
我们使用在CIFAR-10数据集上学习得到的最佳cell,在ImageNet数据集上开展了多组实验。需要注意的是,我们仅仅将网络架构从CIFAR-10迁移到ImageNet,而所有ImageNet模型的权重都是从头开始训练的。
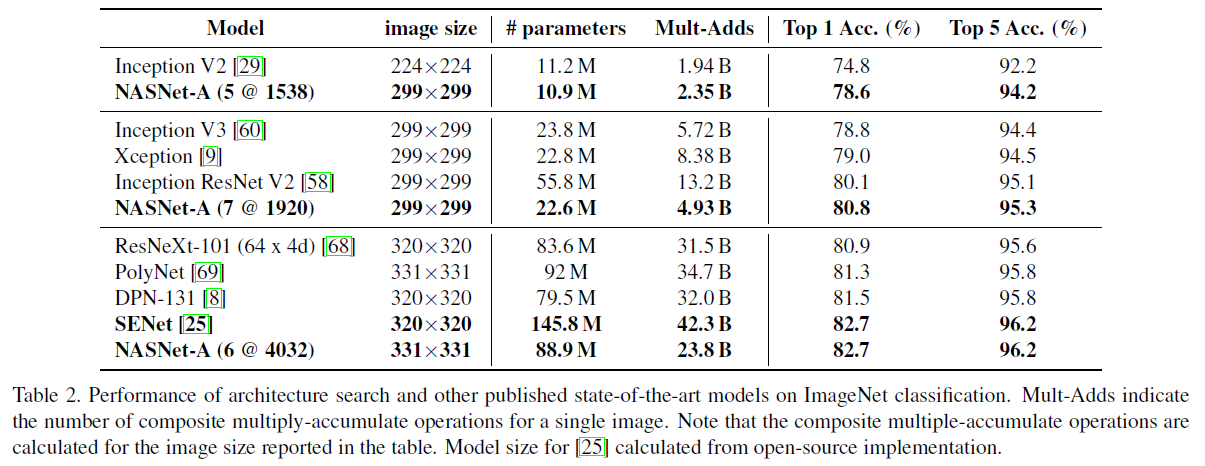
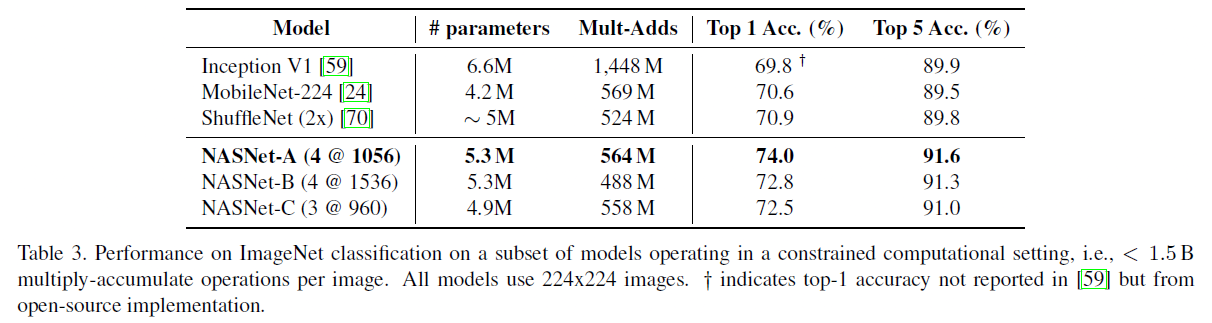
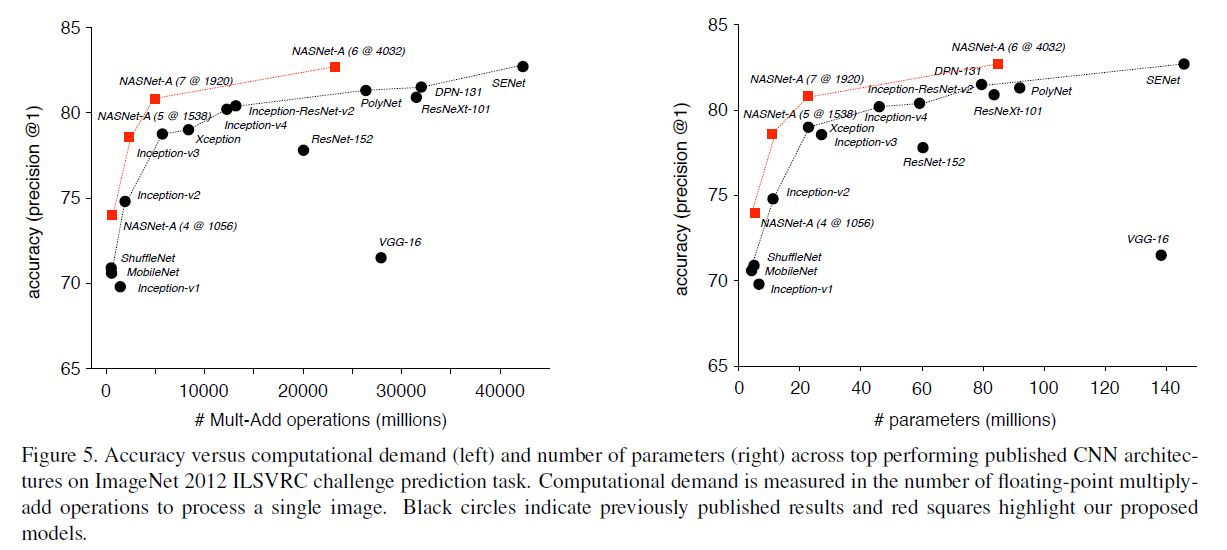
需要注意的是,我们并没有在cell之间额外设置残差连接,因为模型能够自行学习跳跃连接。并且通过实验,我们发现,在cell之间人为添加残差连接并不能改善模型性能。
4.3.Improved features for object detection
我们将在ImageNet上预训练的NASNet-A系列网络接入Faster R-CNN目标检测框架。随后,我们在COCO数据集上重新训练整个目标检测系统。训练数据包括COCO的训练集和验证集,但排除了其中用于mini-validation的8000张图像。
我们采用单模型评估方式,每张图像使用300-500个RPN候选区域,换句话说,我们只将一张图像输入一个网络进行一次推理。
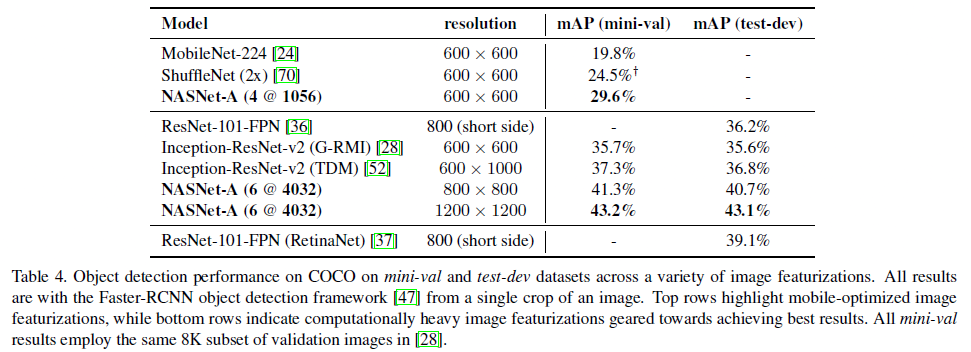
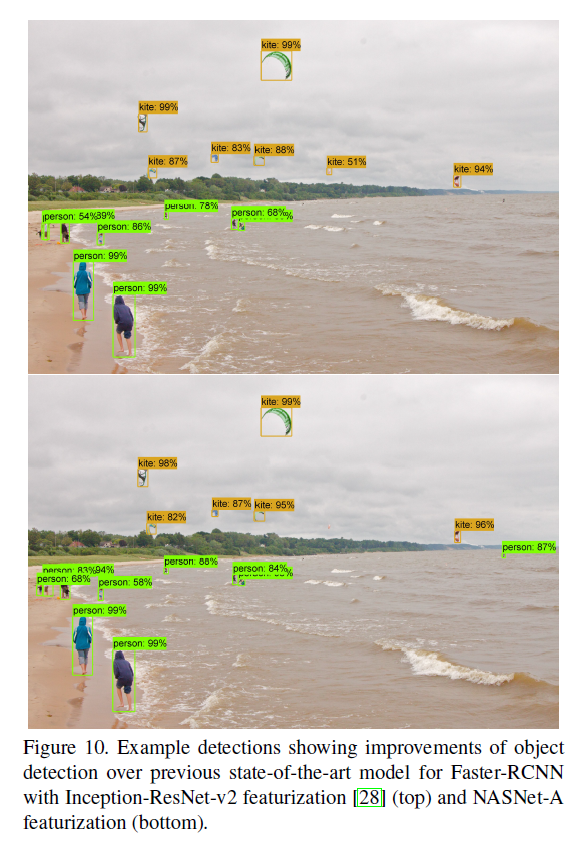
附录C的Fig10和Fig11还展示了使用NASNet-A+Faster R-CNN生成的四个目标检测结果示例。
4.4.Efficiency of architecture search methods
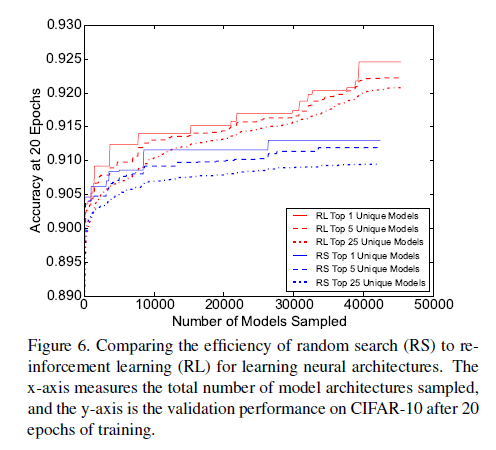
本部分主要为了说明强化学习搜索算法究竟有多有效。在相同计算资源预算下,我们将强化学习与暴力随机搜索进行比较。Fig6展示了随着采样得到的网络架构数量不断增加,强化学习(RL)与随机搜索(RS)各自取得的性能表现。
5.Conclusion
对全文的总结,不再赘述。
6.Appendix
6.A.Experimental Details
6.A.1.Dataset for Architecture Search
CIFAR-10数据集包含60000张$32 \times 32$的RGB图像,涵盖10个类别,包含50000张训练图像和10000张测试图像。我们从训练集中随机划分出5000张图像,作为控制器RNN的验证集。所有图像首先经过whitened处理,然后进行一系列数据增强操作:我们从尺寸为$40 \times 40$的上采样图像中随机裁剪出$32 \times 32$的图像区域,并进行随机水平翻转。
6.A.2.Controller architecture
控制器RNN采用一个单层LSTM网络,每层包含100个隐藏单元。为了预测两种cell的结构,控制器共进行$2 \times 5 B$次softmax预测,其中$B$通常设置为5。这$10B$次预测,每次都对应一个被选中动作的概率。
我们采用PPO来训练控制器,学习率设置为0.00035。为了鼓励探索,我们还使用了entropy penalty(个人注解:entropy penalty的作用是鼓励策略保持较高的熵,避免过早收敛到少数动作,从而促进探索),其权重设置为0.00001。在我们的实现中,baseline函数使用历史reward的指数移动平均来计算,其权重设置为0.95。控制器的权重使用均匀分布进行初始化,初始化范围为-0.1到0.1。
6.A.3.Training of the Controller
采用分布式训练,详情不再赘述。
6.A.4.Details of architecture search space
- 所有卷积操作均采用ReLU函数。我们也尝试过ELU激活函数,但实验发现,ELU激活函数带来的性能提升非常有限。
- 为确保cell内部各个张量的形状始终能够匹配,我们会在必要的位置插入$1 \times 1$卷积。
- 我们使用的所有深度分离卷积在depthwise卷积和pointwise卷积之间均不使用BatchNorm或ReLU激活函数。
- 所有卷积操作均按照如下顺序执行:ReLU、卷积、BatchNorm。
- 每当网络架构选择深度分离卷积作为某个操作时,我们都会将其执行两次,因为我们发现这样能改善模型的整体性能。
6.A.5.Training with ScheduledDropPath
我们对多种随机正则化方法开展了一系列实验。我们发现传统的dropout反而会降低模型性能。然而,我们发现了一种新的技术,称为ScheduledDropPath。它是对DropPath的改进,能够很好地对NASNet进行正则化。在DropPath中,我们以某个固定概率,随机丢弃cell内部的每一条路径,这里的路径指的是Fig4中连接黄色框的边。在训练阶段,随机丢弃模型中的完整计算部分;到了测试阶段,则根据训练时保留这些路径的概率,对路径输出进行相应缩放。但是我们发现单独使用普通的DropPath对NASNet的训练帮助并不大。反而,如果在整个训练过程中,让路径被丢弃的概率线性增加,那么可以显著提高NASNet在CIFAR和ImageNet中的性能。我们将这种方法命名为ScheduledDropPath。
6.A.6.Training of CIFAR models
学习率采用cosine decay策略。momentum系数设置为0.9。使用L2权重衰减。在架构搜索过程中,每一种候选网络架构都会在CIFAR-10数据集上训练固定的20个epoch。我们还发现,在架构搜索阶段,将CIFAR模型的cell重复次数设置为较小的$N=2$,能够使模型训练的相当快,同时仍然可以找到在堆叠更多cell后依旧表现良好的cell结构。
6.A.7.Training of ImageNet models
我们使用ImageNet 2012 ILSVRC图像分类数据集,该数据集包含约120万张图像,涵盖1000个类别。总体而言,我们的训练和测试流程与论文“Rethinking the Inception Architecture for Computer Vision”基本相同。ImageNet模型使用分辨率为$299 \times 299$或$331 \times 331$的图像进行训练和评估,并采用论文“Rethinking the Inception Architecture for Computer Vision”中介绍的相同数据增强方法。我们使用RMSProp优化器,其decay设置为0.9,epsilon设置为1.0。在模型评估时,我们使用训练过程中模型参数的滑动平均值进行计算,其衰减系数设置为0.9999。与论文“Rethinking the Inception Architecture for Computer Vision”相同,我们对所有ImageNet模型使用label smoothing,其参数设置为0.1。此外,所有模型都会在网络大约三分之二深度的位置设置一个辅助分类器。与论文“Rethinking the Inception Architecture for Computer Vision”相同,辅助分类器对应的损失函数权重设置为0.4。通过实验,我们发现,网络性能对辅助分类器的参数数量以及辅助分类器损失函数的权重并不敏感。所有模型还使用L2正则化。学习率衰减策略采用论文“Rethinking the Inception Architecture for Computer Vision”中使用的指数衰减方法。此外,我们还对最终softmax分类层使用dropout,其丢弃概率设置为0.5。
6.B.Additional Experiments
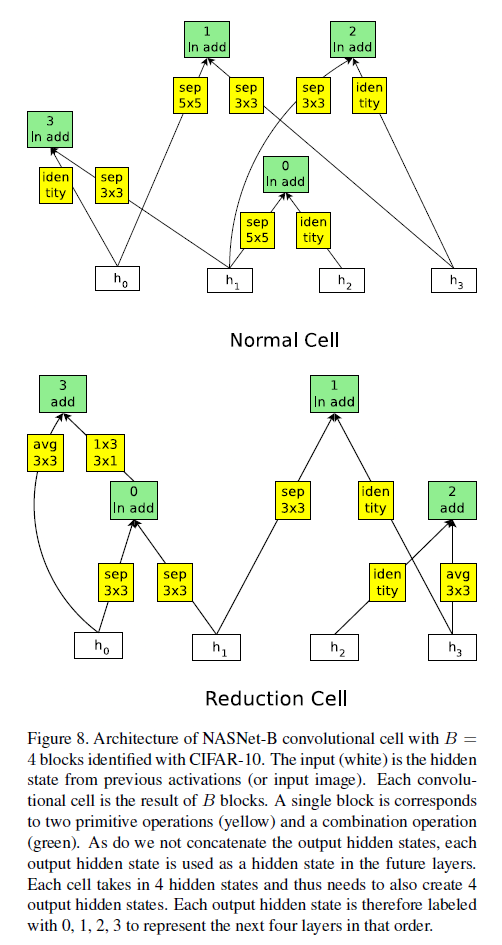
在Fig4中,我们展示了在CIFAR和ImageNet上表现良好的cell结构,称为NASNet-A。接下来,我们介绍另外两种表现良好的cell结构:NASNet-B和NASNet-C。
NASNet-B的结构搜索策略和NASNet-A略有不同。对于NASNet-B,一个cell的输入是上一个cell中所有block的输出。比如,在NASNet-B中,我们设置$B=4$,那么每个cell会接收4个hidden state作为输入,这4个hidden state就来自上一个cell中的4个block输出。此外,在cell内部的组合操作中,除了原有的加法和concat,我们还允许另外两种操作:1)加法后接layer normalization;2)加法后接instance normalization。最终,NASNet-B的cell结构如Fig8所示:
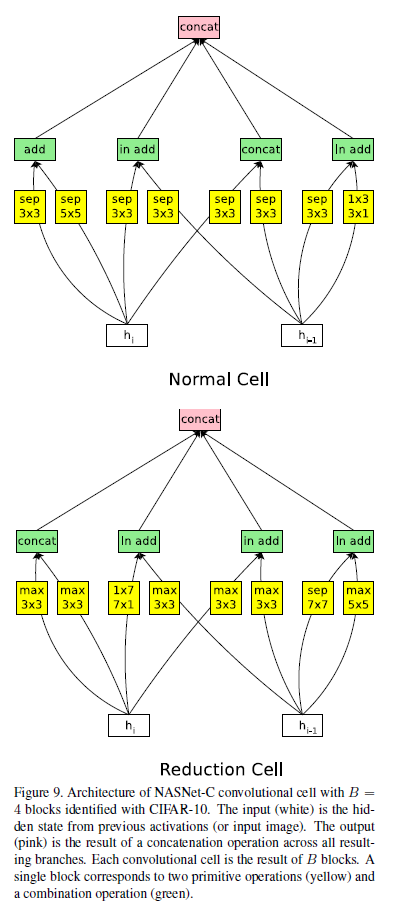
NASNet-C和NASNet-A在搜索策略上的唯一不同是允许在加法后接layer normalization或instance normalization。NASNet-C的cell结构见Fig9:
6.C.Example object detection results
在COCO数据集上目标检测的一些结果:

7.原文链接
👽Learning Transferable Architectures for Scalable Image Recognition