本文为参考李宏毅老师的”Deep Reinforcement Learning, 2018”课程所作的个人笔记。
课程YouTube地址:Deep Reinforcement Learning, 2018。
本文为原创文章,未经本人允许,禁止转载。转载请注明出处。
1.Imitation Learning
由于在很多场景中,可能并不能拿到奖励,所以可以让agent通过观察expert的行为来学策略。接下来介绍两种imitation learning的方法:
- Behavior Cloning
- Inverse Reinforcement Learning
2.Behavior Cloning
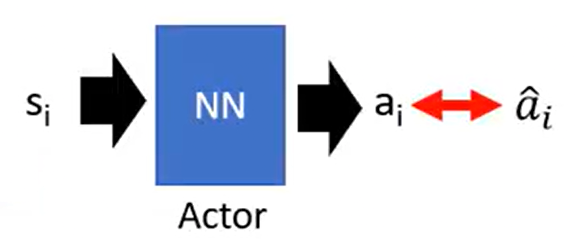
我们可以先收集在面对不同状态时,expert做出的动作:$(s_1,\hat{a}_1),(s_2,\hat{a}_2),(s_3,\hat{a}_3),…$,将这些作为训练数据,使用有监督学习的方法,让agent模型的输出尽可能的接近expert的选择:
但是上述方法存在一个问题,当agent自己执行时,如果犯了一个小错误,导致出现了一个训练数据中没有的状态,此时agent就不知道如何处理才是对的,后续可能会错上加错,误差不断累积。为了解决这个问题,引入Dataset Aggregation。
Dataset Aggregation的思路是,一开始先用expert数据进行训练,得到策略$\pi$,然后让策略$\pi$去和环境互动,它可能会得到一些训练数据中没有的状态,此时再请expert告诉它在这种状态下该怎么做,把这些新数据加入训练集,重新训练,反复进行该流程。这样agent就逐渐学会不仅正常情况下怎么做,犯错以后也知道怎么恢复。
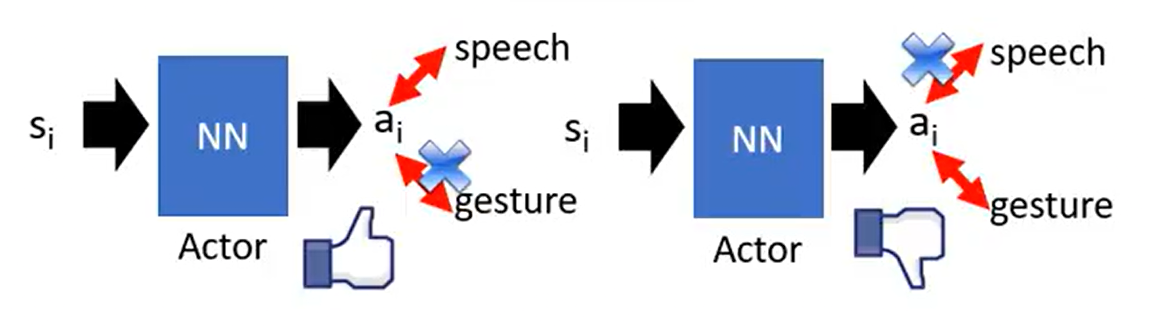
Behavior Cloning还有一个问题就是,如果模型容量有限,它可能学会了“看起来像expert,但对任务没用”的行为,却忽略真正重要的行为。比如在学习一门语言时,expert可能既有发音也有手势,模型就有可能只学到了不重要的手势:
3.Inverse Reinforcement Learning
常规的reinforcement learning的流程如下:
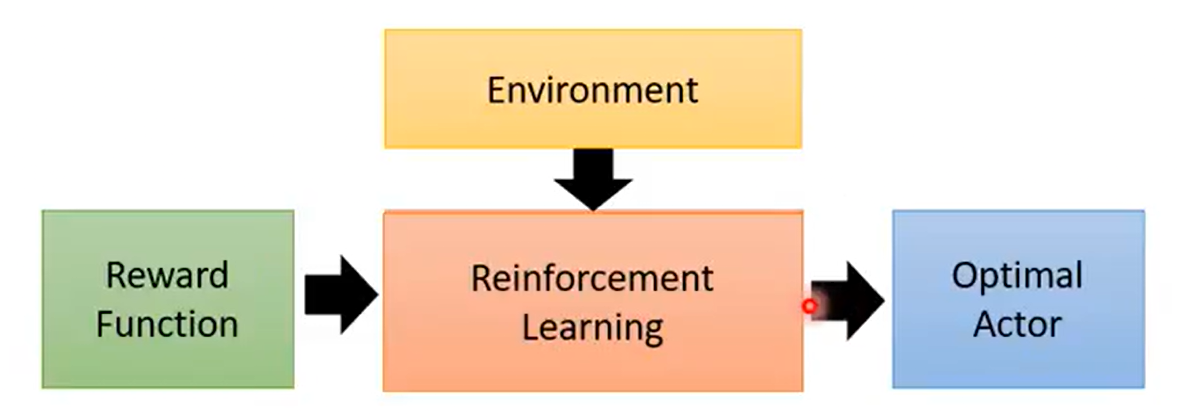
而inverse reinforcement learning(简记为IRL)则是基于expert数据(用$\tau$表示expert做出的轨迹)来反推奖励函数:
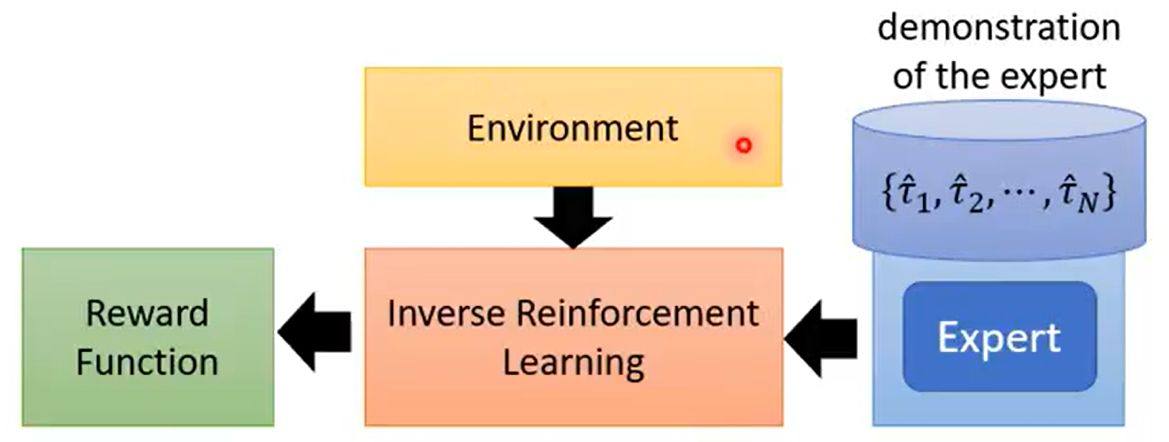
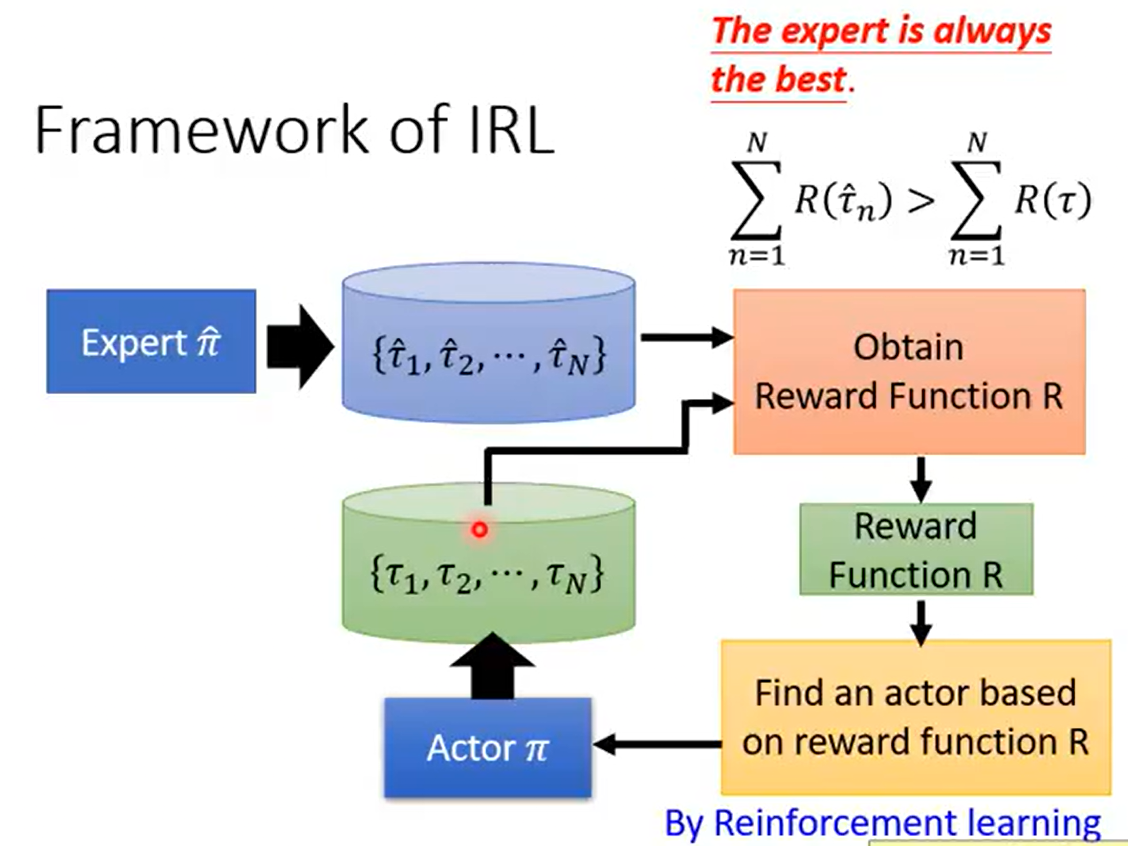
得到奖励函数后,再按照常规的reinforcement learning流程来学习最优策略。IRL更详细的流程见下,expert和actor分别生成多个轨迹,我们需要找到一个奖励函数,让expert的累积奖赏大于actor,然后基于这个找到的奖励函数,按照常规的RL流程,优化actor,之后重复上述过程。