本文为参考李宏毅老师的”Deep Reinforcement Learning, 2018”课程所作的个人笔记。
课程YouTube地址:Deep Reinforcement Learning, 2018。
本文为原创文章,未经本人允许,禁止转载。转载请注明出处。
1.Sparse Reward
sparse reward可以理解为agent在大多时间步都拿不到任何有效奖励,只有在少数关键时刻,比如“任务成功”或“任务失败”时,才能得到非零奖励。这就导致agent很难知道哪个动作是对的,会让模型训练变得非常困难。本文将介绍几种解决办法。
2.Reward Shaping
reward shaping的核心思路就是人为加入中间奖励。
3.Intrinsic Curiosity Module
下图是常规的RL流程:
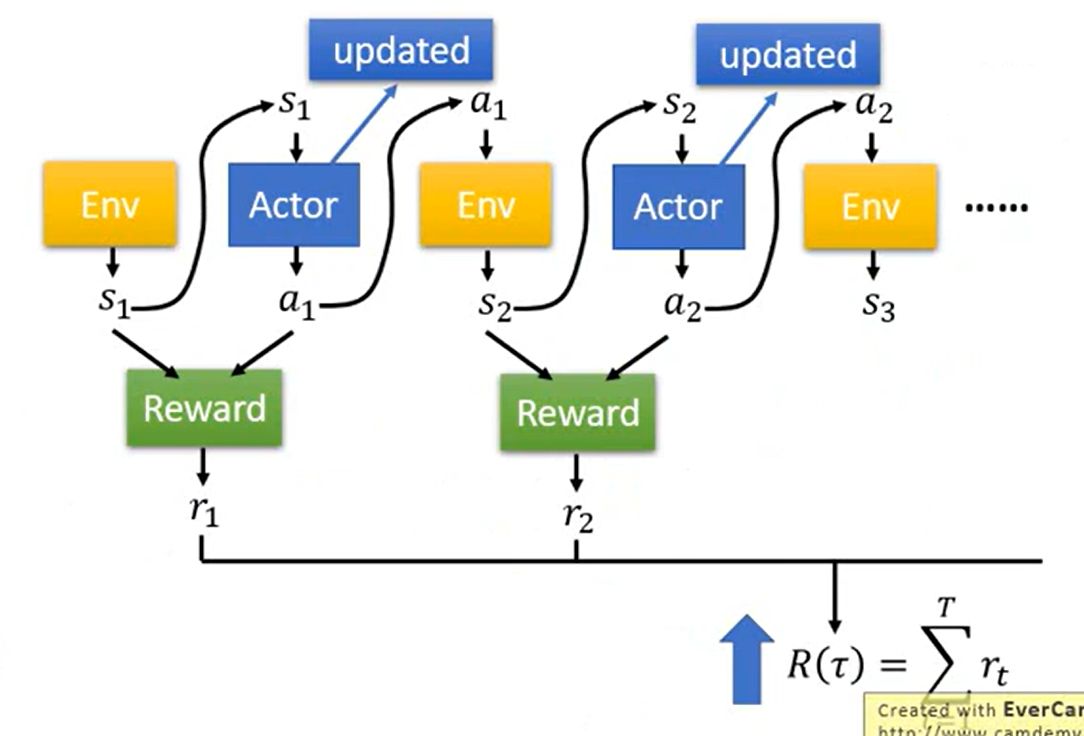
现在,我们可以加上ICM(Intrinsic Curiosity Module):
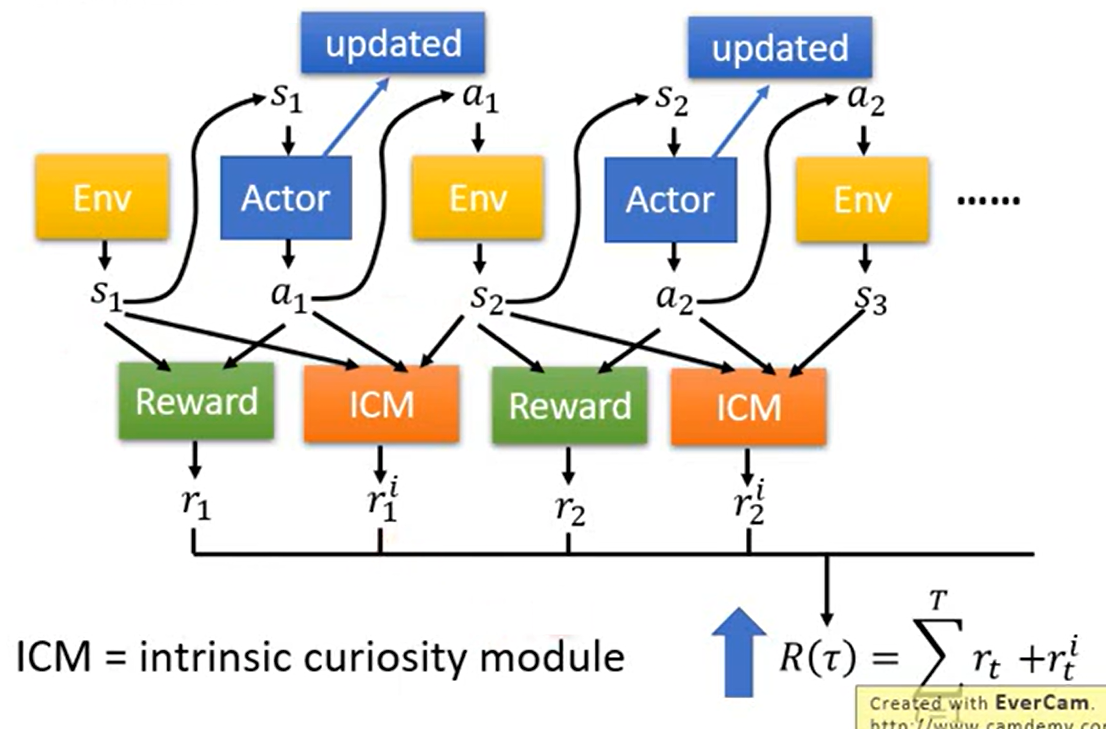
ICM的原始设计见下:
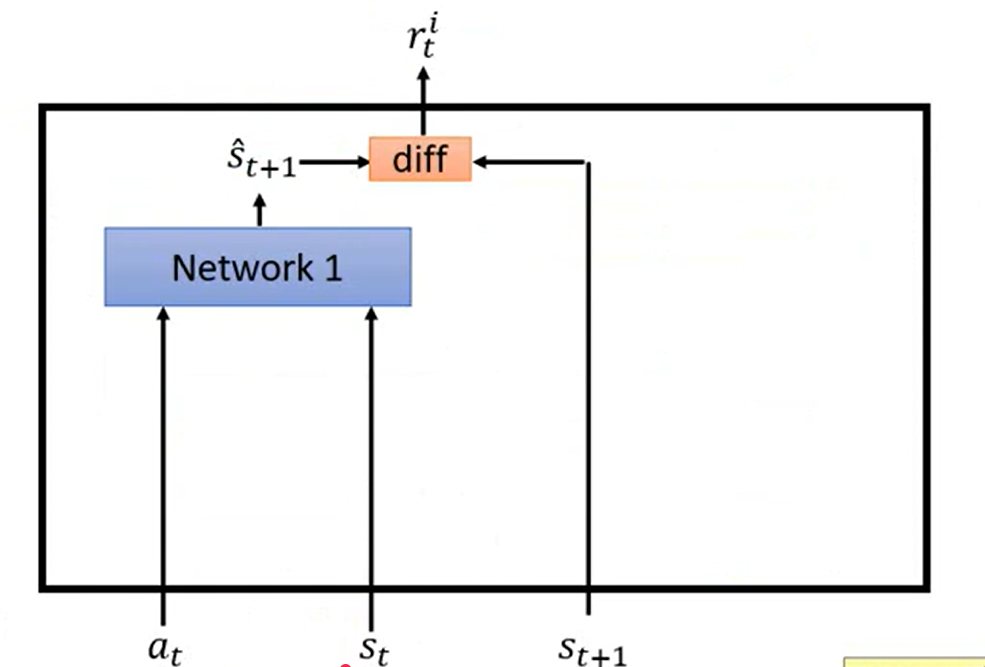
模块输入为当前状态$s_t$、当前选择的动作$a_t$以及下一状态$s_{t+1}$。输出为奖赏$r_t^i$。其中“Network 1”的输入为$s_t,a_t$,输出为预测的下一状态$\hat{s}_{t+1}$。如果$\hat{s}_{t+1}$和$s_{t+1}$差异越大,则$r_t^i$就越大。也就是说,ICM的核心思路就是如果一个状态让我很难预测,那么它对我来说就是新奇的,应该奖励我去探索。
但是上述设计存在一个问题,难被预测的状态不一定是重要的,所以我们还要考虑这个状态是否重要,因此将ICM更新为如下形式:
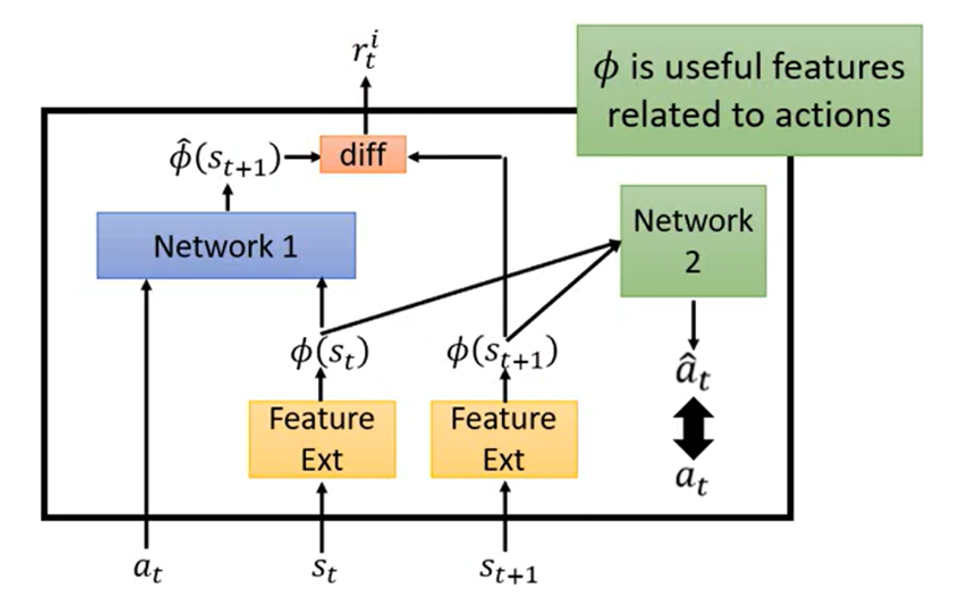
在上图中,两个黄色块为特征提取器,用于滤掉一些不重要的信息。我们期望“Network 2”的输出$\hat{a}_t$和$a_t$越接近越好。
4.Curriculum Learning
curriculum learning的核心思路就是:不要一上来就让agent做最难的任务,而是先从容易成功、容易拿到reward的任务开始,再逐渐提高难度。
5.Hierarchical Reinforcement Learning
举个例子解释一下几种方法的区别,以走迷宫为例,假设左下角为起点,右上角为终点,只有到达终点时才能获得奖励,中间步数都没有奖励,这就是sparse reward。
- 对于方法reward shaping,迷宫的地图、起点和终点都没变,但是我们会给中间步数添加一些奖励,比如这一步使得离终点更近,那么奖励+1,如果这一步使得离终点更远,则奖励-1,其核心理念就是原有的reward太稀疏,添加更多中间反馈。
- 对于方法curriculum learning,我们可以保持原有的reward机制,但在训练初期,让起点离终点很近,随着训练的进行,把起点设置的越来越远。
- 对于方法hierarchical reinforcement learning,我们可以将起点到终点这个问题拆分为起点到中央、中央到终点两个问题,对于起点到中央,我们再拆分为起点到A点、A点到中央,以此类推,让模型去逐个完成底层容易的任务。